[基模杂谈]代码预训练数据管线经验杂谈
Jasaxion / 2026-09-28
随着蒸馏实验的不断发展,现在越来越多的研究发现数据产生的价值越大越模型架构等,把数据做好模型能力有稳步的提升。代码数据预训练的来源和流程,优化路径包括:去重、模型打分、合成数据与过程数据融合,助力模型性能提升。
写在前面:显卡负责计算,数据负责决定算什么
这篇文章起源于我之前在 JD 参与 JoyAI-LLM-Flash 预训练过程中的一些经验记录。这里不展开未公开的数据配方和内部实验,而是把这段时间关于代码预训练的思考,与公开论文、数据集和工程实践放在一起,重新梳理一遍。
我越来越认同一句不太严谨、但很有工程现场感的话:一个好的基座模型,离不开“数据 + Infra”。显卡当然重要,不过把同一份样板代码训练十遍,显卡只会认真地帮你算十遍,不会主动弹窗提醒:“老板,这个我是不是昨天见过?”
严格说,模型能力是数据分布、模型结构、训练目标、计算预算、优化策略和评测共同作用的结果。本文不打算证明架构不重要,而是讨论一个更实际的问题:当模型和预算大体确定以后,我们还能怎样通过数据,让每一份算力花得更明白?
我的关注点也因此从“又收到了多少 TB”逐渐转向几件事:收进来的究竟是什么;模型实际看了多少次;样本是否对应想要的能力;涨分来自有效学习,还是碰巧把考卷也收了进来。
一、数据规模的几种统计口径
读预训练报告时,首先要确认“数据量”指什么。抓取体积、去重后的语料量、模型累计看到的 token 数,经常出现在同一张表里,却不能直接比较。
| 资产 | 实际问题 | 常见误读 |
|---|---|---|
| 抓取与存储字节 | 下载、解压或存储了多少数据? | 把压缩体积、源码字节、重复出现的字节混为一谈 |
| 文件条目与唯一内容 | 某文件出现在哪些仓库?有多少不同正文? | 把目录清单条目当成已下载且唯一的源文件 |
| 唯一语料 tokens | 去重、筛选后有多少可用内容? | 忽略 tokenizer、数据版本和过滤范围 |
| 累计训练 tokens | 经过采样和重复,模型一共看了多少? | 把多轮训练消耗当成独立新数据 |
| 有效监督 tokens | 多少位置实际计算了训练损失? | 把 padding、仅作上下文的内容也算成等量监督 |
例如,Seed-Coder 的 GitHub 文件语料约有 1T unique tokens,整个预训练累计消耗却是 6T tokens,其中还包含代码相关网页、数学相关网页和后续阶段的数据。Phi-1 使用的语料约为 7B tokens,多轮训练后的累计消耗则略超 50B。[5][14]
这几种口径分别影响数据覆盖、重复次数和成本估算。长上下文训练还要多看一项:输入中有多少 token 只作上下文,多少位置实际计算 loss。两个实验即使输入 token 数相同,监督量也可能不同。
本文后面出现的数字,尽量说明它是“原料池”“训练子集”还是“累计消耗”。跨论文的 token 数如果没有统一 tokenizer,就先当量级参照,不急着算精确增长倍数。
二、经典 The Stack 三代,不只是越来越大,也是在重新定义“可用”
2026年代码数据的主线是”去掉人的手工规则,加上可验证的信号“。
流水线已经收敛成一个共同栈:抓取–>精确去重–>跨语言近去重–>最少量规则前置–>模型打分/分类器筛选–>分阶段配比–>仓库级打包+FIM;
而真正拉开差距的三件事是:合成数据的形态(改写型 vs 教科书型vs可验证型) 、软件演化过程数据(commit/PR/issue) 、以及 midtraining的时机与配比。
开源代码数据:Stack 三代
| 版本 | 时间 | 原始规模 | 训练切分 | 语言 | 关键变化 |
|---|---|---|---|---|---|
| Stack v1 | 2022 | 6.4TB | ≈200B Token | 358 | 首次把“许可合规的大规模代码”做成公共品;opt-out 机制 |
| Stack v2 | 2024 | 67.5TB | ≈550B Token | 600+ | 基于 Software Heritage, SWHID 溯源;但内容需二次获取 |
| Stack v3 | 2026.07 | 113.7TB / 224M 仓库 / 约 439 亿文件 | ≈4.9T Token / 15.9TB /173 M 仓库 | 713(train) / 770(full) | 直爬 GitHub、内容内联、跨语言去重、修掉v2的去重缺陷 |
The Stack v1:抓取、许可筛选与退出机制
The Stack 最初论文介绍的是约 3.1 TB、30 种编程语言的宽松许可源码集合。后来 v1 系列继续扩展,才出现 6.4 TB、358 种语言等常见口径。它们对应不同版本,不能都当成最初论文的统计结果。[1][2]
它的基本思路可以这样理解:
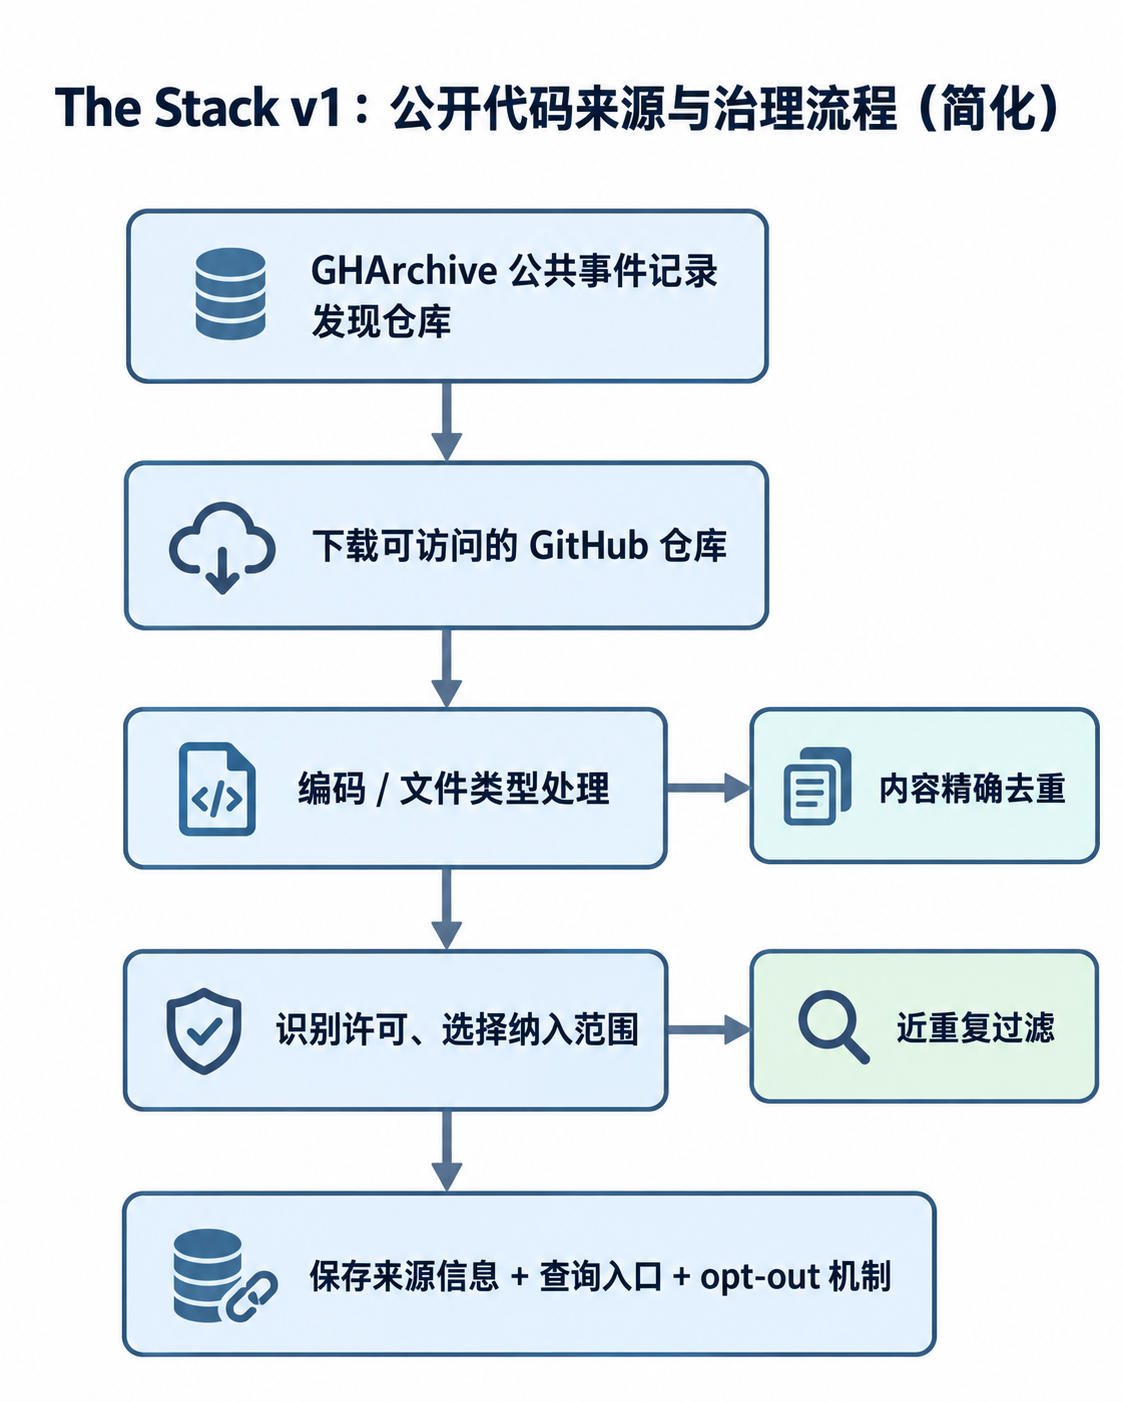
v1 先通过 GHArchive 公共事件记录发现仓库,再下载可访问的代码,进行编码与文件类型处理、精确去重、许可筛选和近重复过滤。GHArchive 在这里提供的是仓库线索,代码正文仍需另外获取。论文从事件中提取约 2.21 亿个仓库名,实际下载约 1.37 亿个仓库;这些原始抓取量与最终许可子集的规模不同。[1,§3]
许可政策也经历过调整。v1 数据卡记录,早期被归入 permissive 的 MPL、EPL、LGPL,后来因属于弱 copyleft 被移出相应范围。[2] 这说明许可判断需要保留依据和版本。只存一个 is_safe=true ,以后很难知道它依据的是哪一版识别结果和政策。
论文同时做了去重实验。在 350M 模型、Python 子集的宽松许可设置下,近去重后 HumanEval pass@1 从 10.99 提升到 13.94,MBPP 从 11.60 提升到 15.94。[1,表5–6] 这个结果支持该设置下的近去重方案,但阈值仍需随语言、数据来源和模型预算重新评估。
除了数据本身,v1 还提供来源查询和 opt-out 机制。后续团队可以据此追溯代码来源,并处理退出请求,这部分能力需要在自己的派生数据中继续保留。
v1 的意义可以概括为:公开代码不再只是一个巨大的下载目录,而开始成为带有来源和治理机制的研究资产。
The Stack v2:利用 Software Heritage 组织源码
The Stack v2 借助 Software Heritage(SWH)的软件归档图获取数据。SWH 用内容寻址结构组织文件、目录、版本与快照,便于去重存储和历史定位。[3][4]
这里需要区分档案的覆盖范围和训练集的提取范围。SWH 保存了历史对象,但 StarCoder2 的主源码提取选择的是主分支最新 revision,并没有把所有历史版本都纳入训练。[3,§2.1]
v2 的核心流程是:
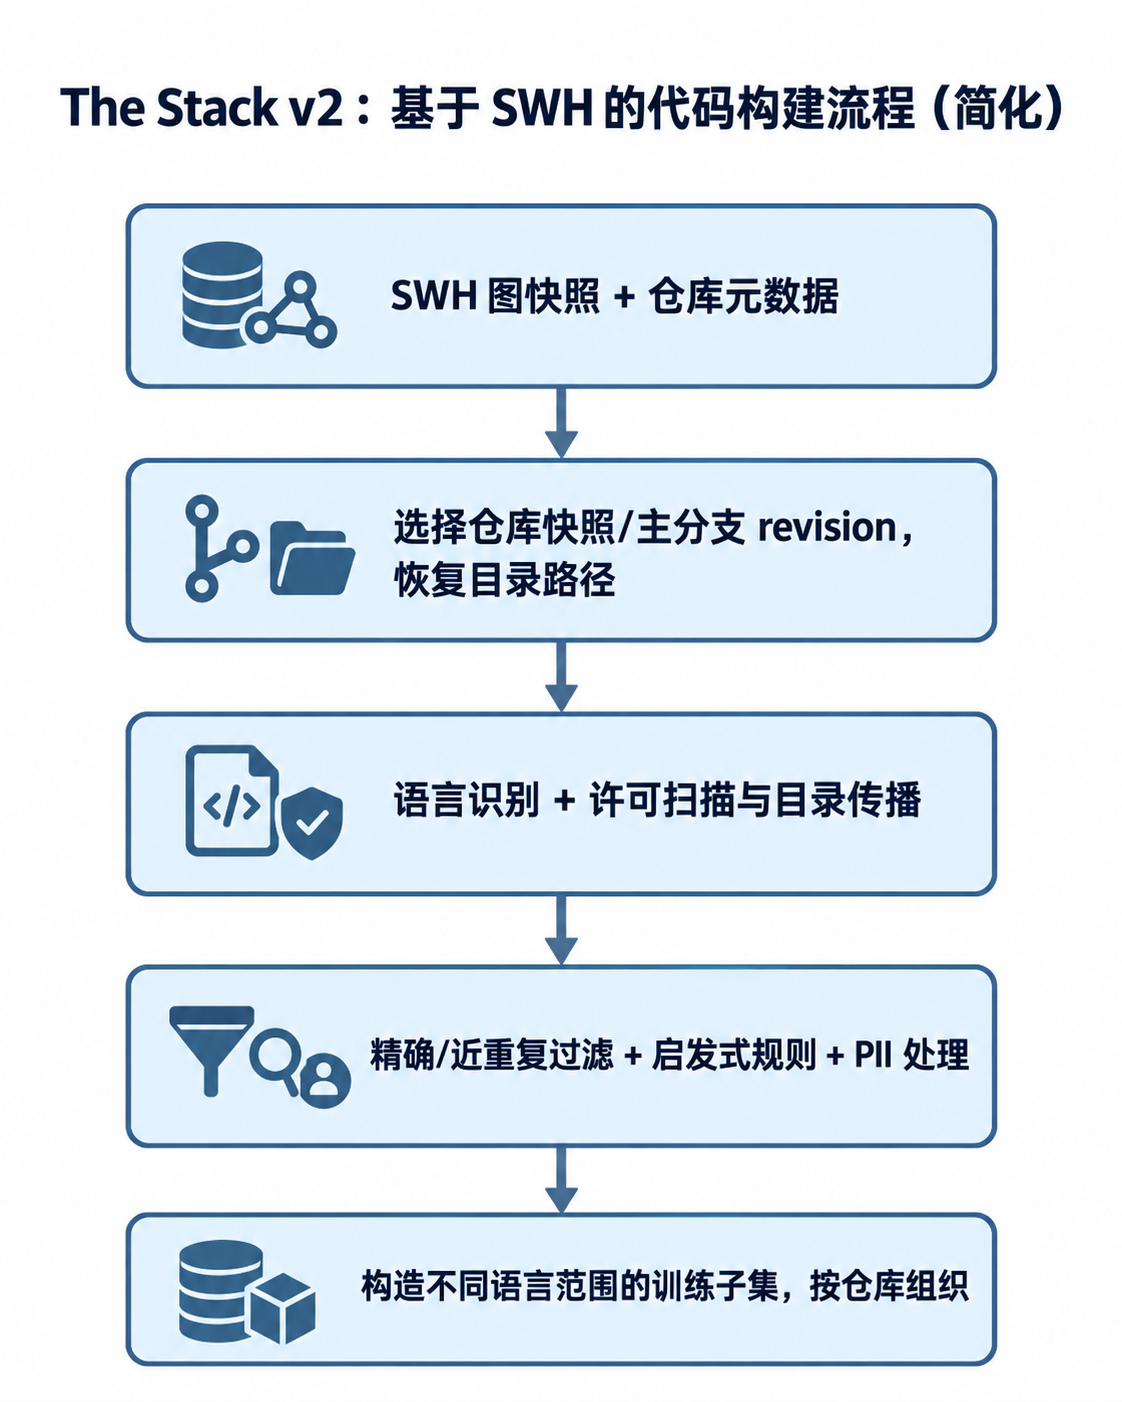
数据卡报告约 3.28B 个唯一文件、67.53 TB,来自约 104.2M 个 GitHub 仓库。[4] 语言识别使用 go-enry 等工具,许可扫描结果则沿目录结构传播到文件。相比仅依赖扩展名和仓库标签,这种处理能表达更细的文件归属关系。[3]
使用 v2 时,内容访问是一项实际成本。公开数据集主要包含 SWHIDs 等标识 ,正文需要按 Software Heritage 的批量访问安排获取。 [4] 下载元数据、取得正文授权和完成大规模读取,是几项不同的工作。
v2 的规模数字也有多种口径:
- v3 回顾表中的 v2 训练子集约为 550B tokens。
- StarCoder2 论文中的全语言代码训练集合为 775B+ unique tokens。
- 加入其他来源后的整体训练集合约为 900B+ unique tokens。
- 模型实际累计训练为 3.3–4.3T tokens。[3][4][6]
这些数字涉及不同发布物和混合范围。引用时最好保留集合名称,而不是只写“Stack v2 有多少 token”。
The Stack v3:内联正文与数据版本修订
BigCode 社区发布 The Stack v3,这是迄今最大的开放代码数据集,包含114 TB 原始数据、 15.9 TB 处理后数据、约 5T 去重tokens,涵盖 770 种编程语言和2.24亿仓库,完全开放且无限制许可。相比2024年的v2(68 TB raw /550B tokens / 618种语言),V3 在规模、语言覆盖和使用便利性上大幅提升,并重新爬取了截至2025 年8月的最新 commit。
数据全集: https://huggingface.co/buckets/HuggingFaceCode/stack-v3-full
2026 年 7 月出现的 The Stack v3 重新直接抓取 GitHub 默认分支快照。官方说明抓取于 2025-08-07 完成,不包含完整 Git 历史。训练版按仓库分组,将 UTF-8 正文放入 files[].content,省去了用户另外获取正文的一步。[6]
初版约 4.9T tokens;截至本次核查,官方 v3.1 修订已将其更正为约 3.6T。 Changelog 的原因是分区错误造成精确重复文件泄漏,而不是发现了四分之一代码“质量不好”。
固定修订 1f61b735bc0a5698345ce2196730f24bfa467f33 的训练统计为:
| 统计项 | 该修订报告值 |
|---|---|
| 仓库记录 | 172,823,131 |
| 保留文件条目 | 2,267,483,994 |
| 源码字节 | 11,501,524,769,560,约 11.50 TB |
| 编程与标记等语言类别 | 713 |
| 估算 tokens | 3,611,282,968,225,约 3.61T |
| 用于估算的 tokenizer | Qwen/Qwen3-Coder-Next-Base |
上表为该修订的官方结构化统计。README 开头仍使用旧值 15.9 TB,版本对照表和结构化统计已更新为约 11.50 TB。[6]
这个修复与管线验收直接相关:即使去重步骤按预期运行,分区、关联和最终输出仍可能重新引入重复。检查应落到最终训练产物,不能只检查中间结果。
v3 有两个发布物:full 保留较完整的元数据和近重复信息,便于重新选择样本;train 则经过代表选择与质量处理,按仓库组织正文。
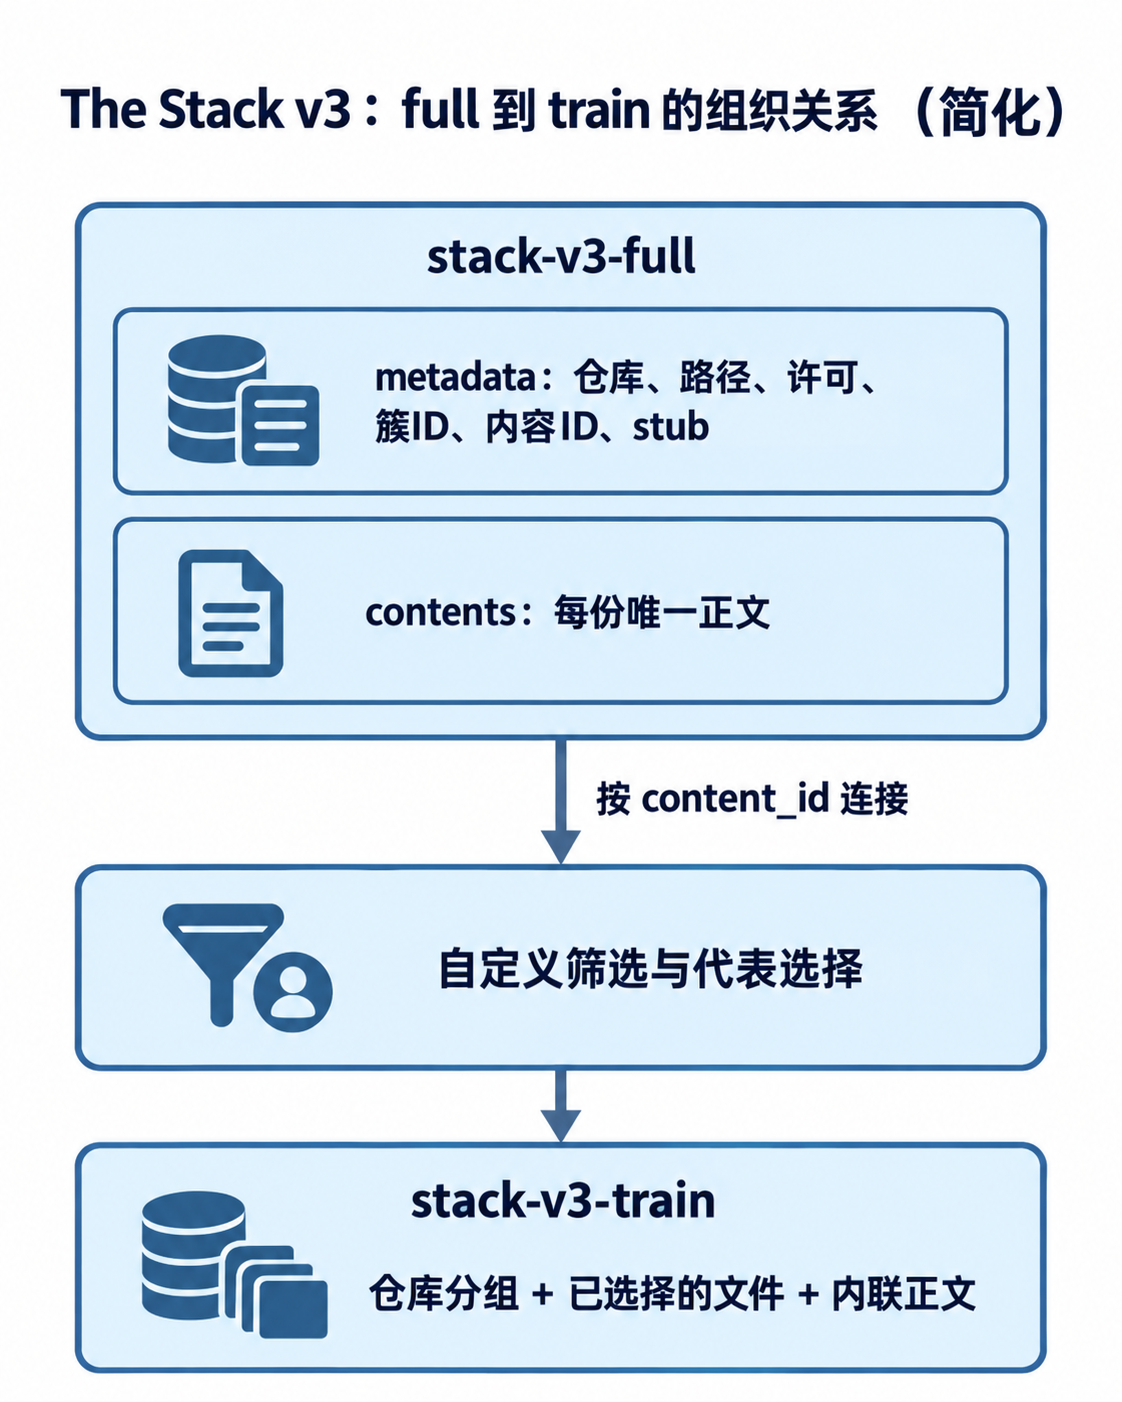
官方对 full 报告约 113.7 TB、224M 仓库和 43.9B 文件条目,其中约 28.3B 是 stub。二进制、超大文件或未识别语言的对象,可能只保留目录清单信息。[6] 因而文件条目数不能视为可直接训练的唯一源码文件数;train 按仓库分组,也不保证过滤后的依赖和文件仍然完整。
近去重方面,v3 跨语言分区运行 MinHash-LSH,并对候选的 Jaccard 估计进行复核,报告的阈值为 0.7。每簇代表依次按 stars、forks、宽松许可和较早的仓库创建时间选择。[6] 这里的跨语言处理用于检查文本重复,不表示能够判断 Python 与 Java 实现是否语义等价。
v3 仍保留了不少启发式过滤。例如,字母占比低于25%的文件会被排除,汇编使用字母数字比例;平均行长超过100或最大行长超过1000字符的规则则有文件类型豁免。此外还有自动生成标记和大块编码内容检查。StarPII用于识别邮箱、密钥、姓名、密码和IP等信息并替换为占位内容,检测仍可能遗漏。[6] 因而模型评分、规则和敏感信息处理应按用途分别配置。
三代数据的变化,可以从获取方式、正文分发和治理能力三个方面理解。规模增长需要结合这些变化来看,尤其不要把不同版本、不同过滤阶段的数字放在一起计算增幅。
Take way: v3 相比v2优化了什么?
内容内联,一行一个仓库。 v2 存的是Software Heritage 标识符,研究者要拿到真实内容还得另做安排——社区吐槽“数据集很棒,代码在哪儿“。V3 直爬 GitHub 默认分支 (截止2025-08-07),把 UTF-8 源码直接放进数据里,“全仓库预训练”从研究话题变成开箱可用的默认。
去重改成跨语言+实测复核。 V2按语言分别做 MinHash;v3一次跑完所有语言,并且不再信任 LSH 索引,而是实测每一对候选的 Jaccard,把估计重叠 ≥70%的聚成簇。这修掉了v2中“比预期多丢文件“的缺陷,C++ 涨 15x、 TypeScript 7.5x , Rust 7x , Python 4.8x(部分是两年新增,部分是 bug 修复)。
保留规则公开且可调。 每簇保留:最多 star –> fork 数 –> 许可宽松度 –> 最早创建时间。这不是中性规则——它把 GitHub 的流行度动力学烘焙进了语料。stack-v3-full 桶保留簇 ID 与过滤前信号,就是为了让不认同这套政策的团队自己重建。
过滤沿用 StarCoder2 的规则集:字母字符 <25%(汇编用字母数字)、存在>1000字符的行、平均行长>100字符、自动生成标记、 大块编码数据。再用 StarPII把邮箱/密钥/ 姓名/密码/IP 替换为占位符。
真正值得继承的不是“一代比一代大”的单向故事,而是:来源治理、内容可得性、过滤可重建性和产物质量,都在成为数据集的一部分。[1–6]
三、代码数据源:GitHub、SWH、Common Crawl
GitHub、SWH 和 Common Crawl 都能提供代码相关内容,但采集方式和附带信息不同。GitHub 等协作平台保留源码、Git 历史、README、issue、PR 和评审记录;SWH 保存实际归档到的软件对象和来源;网页数据则补充教程、文档、问答和博客。[3][4][32]
GitHub 可以查看历史,SWH 也不保证收录每个仓库的全部版本。能否恢复某个历史状态,取决于保存了哪些对象和快照。SWHID 有助于稳定标识对象,但标识存在与正文可访问仍是两回事。
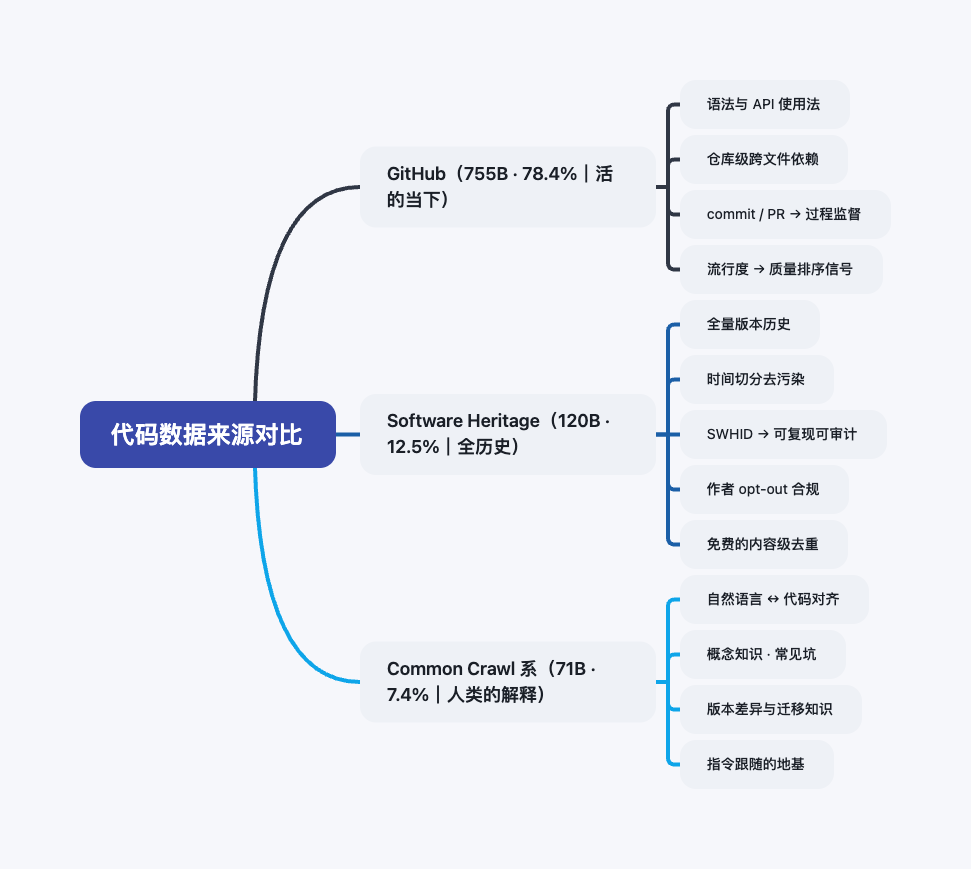
| 维度 | GitHub | Software Heritage | Common Crawl |
|---|---|---|---|
| 本质 | 活的平台 | 死的档案 | 人类的解释 |
| 提供的资产 | 默认分支源码、issue / PR / commit、star / fork / 许可、CI 状态 | 全量版本历史、SWHID 永久标识、已去重的 Merkle 图、跨 forge(GitLab / PyPI / npm / Debian) | 教程、官方文档、博客、Stack Overflow 问答、API 参考 |
| 不可替代之处 | 唯一的天然过程监督来源:改了什么、为什么改、改完过不过 CI | 唯一能回答“两年前这个文件长什么样”,因此也是唯一能做干净时间切分与作者级 opt-out 的路径 | 唯一的自然语言 ↔ 代码大规模对齐语料 |
| 缺什么 | 没有稳定标识(force push / 删库即失效);许可元数据噪声大;无法回溯历史 | 内容分发受法务约束;函数数据集快照有滞后(v2 用的是 2023-09-06 的图) | 候选占比极低(约 3%)、噪声极大;代码片段常不完整、不可执行 |
| Token 占比(RefineCode) | 755B(78.4%) | 120B(12.5%) | 71B(7.4%) |
这些来源还会相互重叠。同一份 README 可以同时出现在 GitHub、SWH 和网页抓取中。如果没有跨来源检查,提高某一来源的比例,可能只是让模型重复看到已有内容。
OpenCoder 的 RefineCode 给出了一个不错的量化例子。论文表 2 中的来源是:[7]
| 来源 | tokens |
|---|---|
| GitHub Code | 755B |
| Jupyter Notebooks | 11B |
| The Stack v2 | 120B |
| Processed Common Crawl | 13B |
| Processed SkyPile | 3B |
| Processed FineWeb | 55B |
| Processed AutoMathText | 3B |
合计约 960B tokens。13B、3B、55B 相加是 71B,但这是三个网页子来源的合计。FineWeb 的上游来自 Common Crawl,也不能把直接来源和上游来源混成一列。
同样,来源占比不能直接说明能力贡献。GitHub Code 占 755B,不表示它只负责某种基础能力;SWH 的可审计性首先是数据管理属性,也不是模型训练后自然获得的一项技能。要判断一个来源的训练价值,需要在固定预算下做替换或移除实验。
许可和敏感信息处理
v3 数据库使用 ODC-By 许可,原始源码仍受各自许可证约束。no_license 表示流水线未识别到许可,不表示代码作者放弃了版权。full 未做 PII 脱敏,train 虽经 StarPII 扫描,官方也明确说明检测并不完美。[6]
因此,使用之前应明确自己的许可政策,并保存原始许可文件、适用路径、识别器版本和来源关联。退出请求、密钥及个人信息风险也要单独处理。质量评分回答的是样本是否适合某种训练目标,不能替代这些判断。
四、经验:把管线做成可以重跑的过程
代码数据处理通常包括采集、精确去重、近去重、语法或格式检查、质量评分、配比与打包。它们看起来是顺序步骤,但实现时不必把所有计算都绑定在一次作业里。
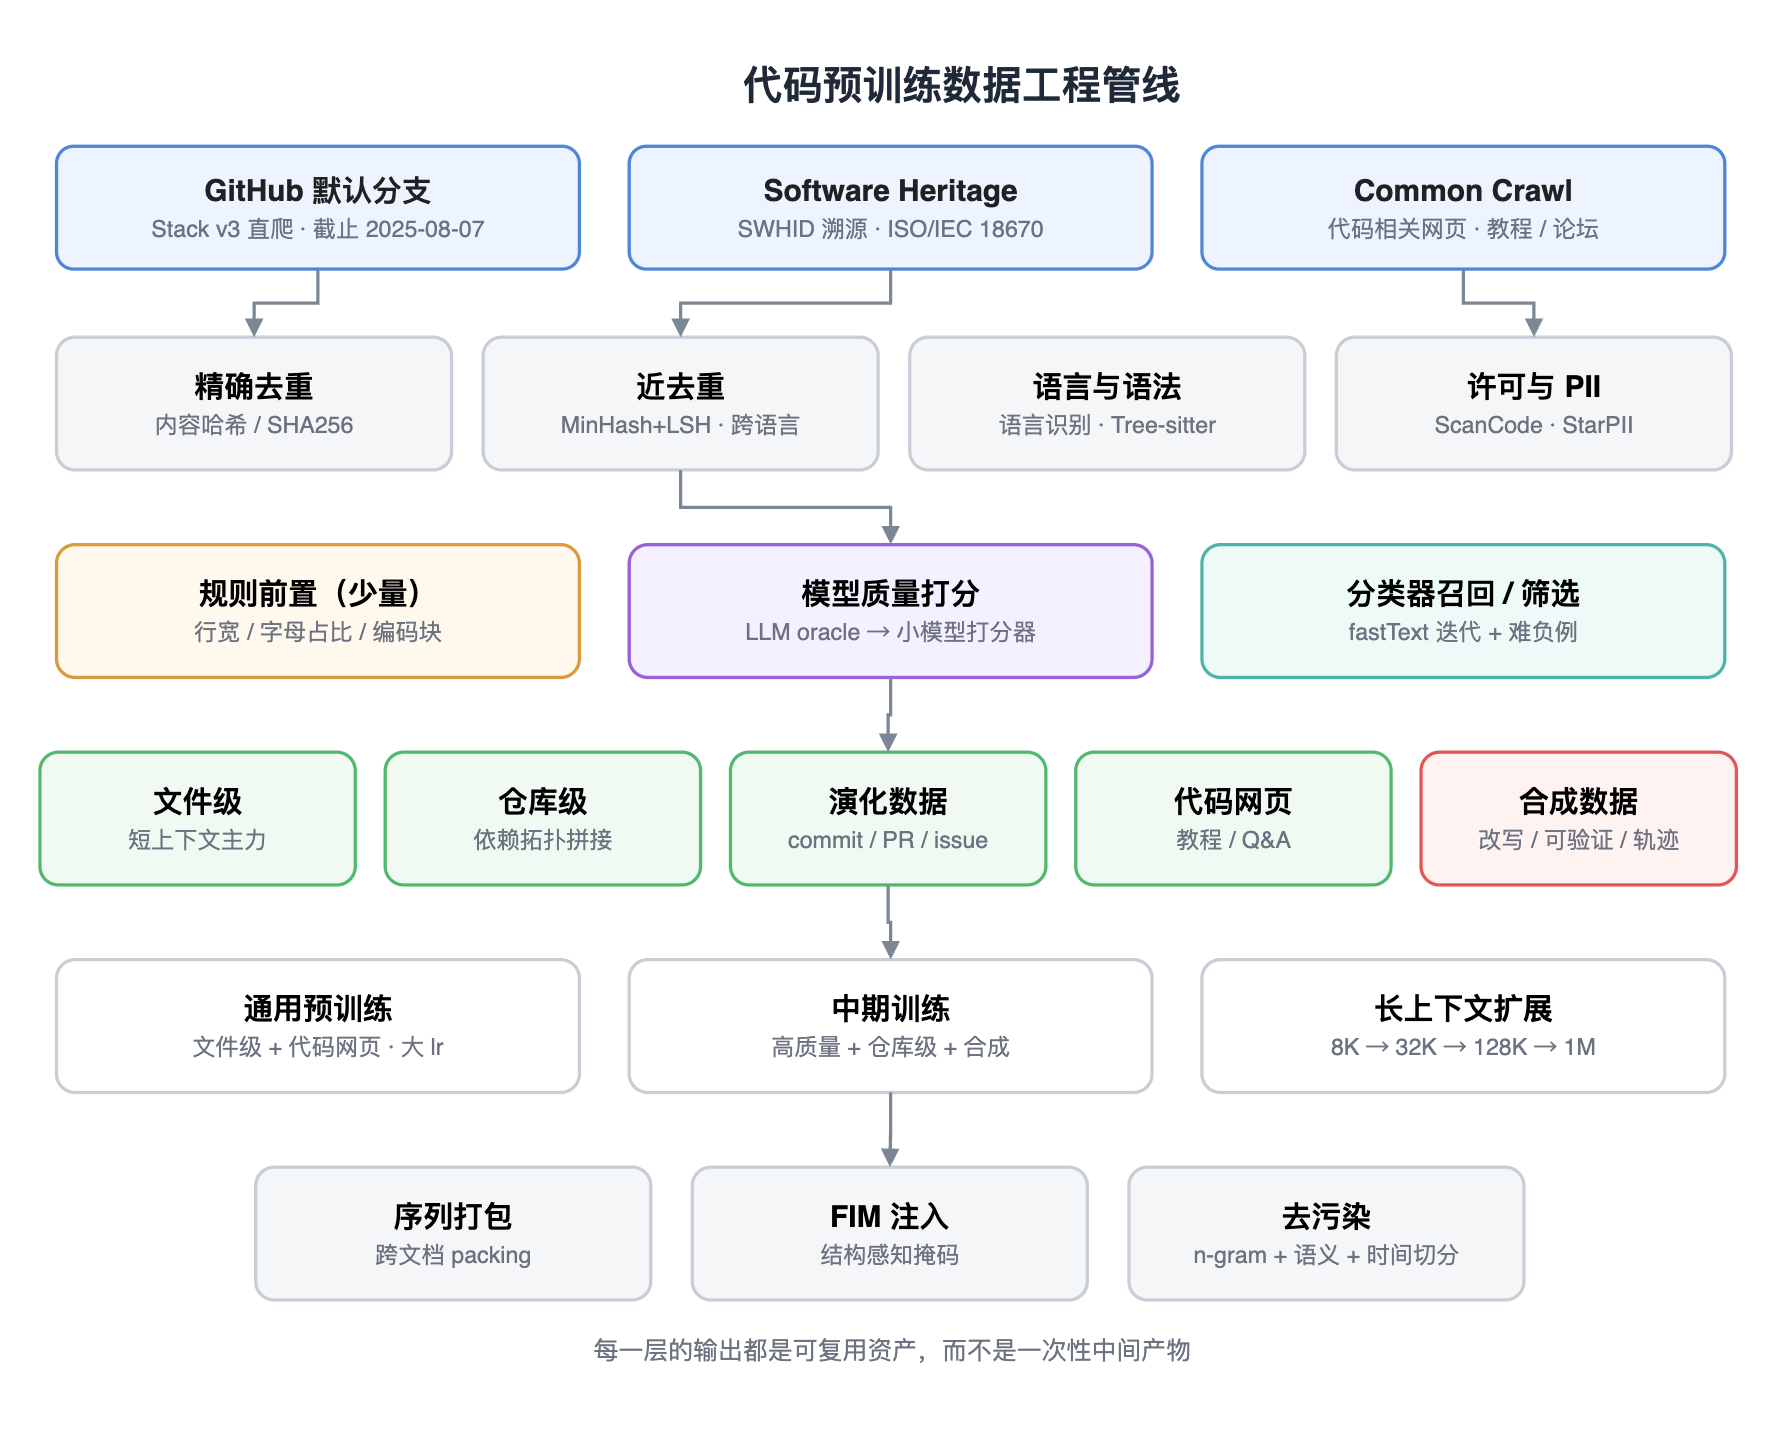
| 做什么 | 典型代价 | 2026 年的默认做法 | |
|---|---|---|---|
| 采集 | 直接爬 GitHub 默认分支 / 用 SWH 档案 / 从 CC 抽代码网页 | 存储与带宽;v3 原始 113.7 TB | 直接爬 + 内容内联(v2 只存指针,被吐槽“数据集在哪儿”) |
| 精确去重 | 按内容哈希折叠,每个文件只存一份 | 几乎免费 | 必做,覆盖率最高收益最大 |
| 近去重 | MinHash + LSH 聚类,每簇留一个代表 | CPU 与 shuffle;是流水线最大瓶颈之一 | 跨语言全局聚类 + Jaccard 复核(v2 是按语言分别做) |
| 语法过滤 | Tree-sitter 解析,剔除语法错误文件 | 便宜 | 作为规则前置的一部分,不做深度语义检查 |
| 质量打分 | LLM 标注小样本 → 蒸馏小打分器 → 全语料推理 | 一次推理全语料;1.3B 打分器是主流折中 | 只滤最差的一档(10% 量级),不做“只留 1% 精品” |
| 配比与调度 | 决定各源在各阶段的采样权重 | 需要小模型消融,一次可信消融是 10⁴ GPU-day 量级 | 三阶段:通用 → 中期(高质量/仓库/合成)→ 长上下文 |
| 打包 | 拼接、FIM 注入、去污染 | 低 | 依赖拓扑拼接 + 结构感知 FIM + 多层去污 |
Seed-Coder 明确采用模块解耦的设计,便于单独运行处理步骤和增量扩展。[5,§2.1] 例如,一个文件已经得到质量分,调整筛选阈值时就可以复用这个分数;改变仓库采样权重,也不需要重新抓取源码。
我会将原始快照、处理特征和最终选择分别保存。前者用于追溯,处理特征包括规则命中、质量分和验证结果,最终选择则记录使用了什么阈值与权重。这样出现效果变化时,至少能够定位是哪一次决策改变了数据分布。
每个阶段都应记录输入文件清单、处理代码和 tokenizer 版本、规则与评分器版本、随机种子、输出摘要,以及文档数、字节数和 token 数。排除样本也值得按语言、来源和长度保留一部分,便于检查误删。
DataTrove 的 MinHash 示例要求,最后读取原始数据并删除样本时,输入来源与任务划分必须和签名生成阶段一致。[30] 如果删除索引使用旧分片的行号,而重跑时输入顺序发生变化,就可能删错对象。这类问题难以从模型分数中直接看出来,应该在数据产物层检查。
⭐️对我来说,Infra 的要求因此包括运行效率,也包括可追踪性和恢复方式:一轮处理用了哪些输入;失败后从哪里继续;参数变化后哪些步骤需要重算。后面的去重、筛选和配比实验,都依赖这些记录。
五、流程 1:去重粒度与训练重复
精确去重与内容规范化
代码重复可能来自 fork、镜像、vendored 依赖、复制脚本、生成代码,或同一内容被多个数据源收录。内容哈希适合作为精确去重基线,但全量读取、解压、哈希、shuffle 和结果回写仍有成本。[7][30]
用于匹配的文本最好与原始文件分开保存。统一换行、删除注释或调整空白,会改变哈希结果,其中一些变换还可能改变语义。Python 缩进就是明显例子。保留原始字节哈希和规范化视图,才能区分文件本身发生变化与查重规则发生变化。
去重是代码数据流水线里最容易被低估的一环。直觉上它是个算法问题(用什么哈希、多少band),但2025-2026年的证据一致指向另一个结论:检测算法已经收敛到一个性价比点,真正決定下游效果的是保留策略——删多少、留哪一份、大簇怎么处置。
MinHash-LSH 的候选概率
把文档切成 shingle 集合后,Jaccard 相似度为:
$$ J(A,B)=\frac{|A\cap B|}{|A\cup B|}. $$理想的独立 MinHash 下,单个签名位置相同的概率等于真实相似度 $s$。LSH 将签名分为 $b$ 个 band,每个 band 有 $r$ 行;只要一个 band 完全相同,就召回这对文档。其候选概率为:
$$ P(\mathrm{candidate}\mid s)=1-(1-s^r)^b. $$FineWeb 使用词级 5-gram、112 个 hash、14×8 分组。在这个固定配置下,相似度与候选命中概率的关系如下:[8]
| 真实 Jaccard 相似度 $s$ | 候选命中概率,近似值 |
|---|---|
| 0.70 | 56% |
| 0.75 | 77% |
| 0.80 | 92% |
| 0.85 | 98.8% |
表中的 0.75 和 0.85 是文档对的真实相似度,而非两次设置的删除阈值。如果系统另外设置了候选复核阈值,在候选集固定的情况下,提高阈值通常只会减少保留的重复边。
实现时,应分别记录 shingle 定义、LSH 召回参数、复核方式和聚簇规则。FineWeb 的这版方案直接对 LSH 匹配做传递聚类,不能将其他方案中的逐对复核步骤套用到它的方法上。[8]
连通聚类还会产生传递关系:A 与 B 相似、B 与 C 相似,并不保证 A 与 C 也超过同一阈值。大簇可能来自大量模板,也可能由少量桥接样本连接而成。只统计删除率不足以判断去重质量,还需要抽查重复边和簇内样本。
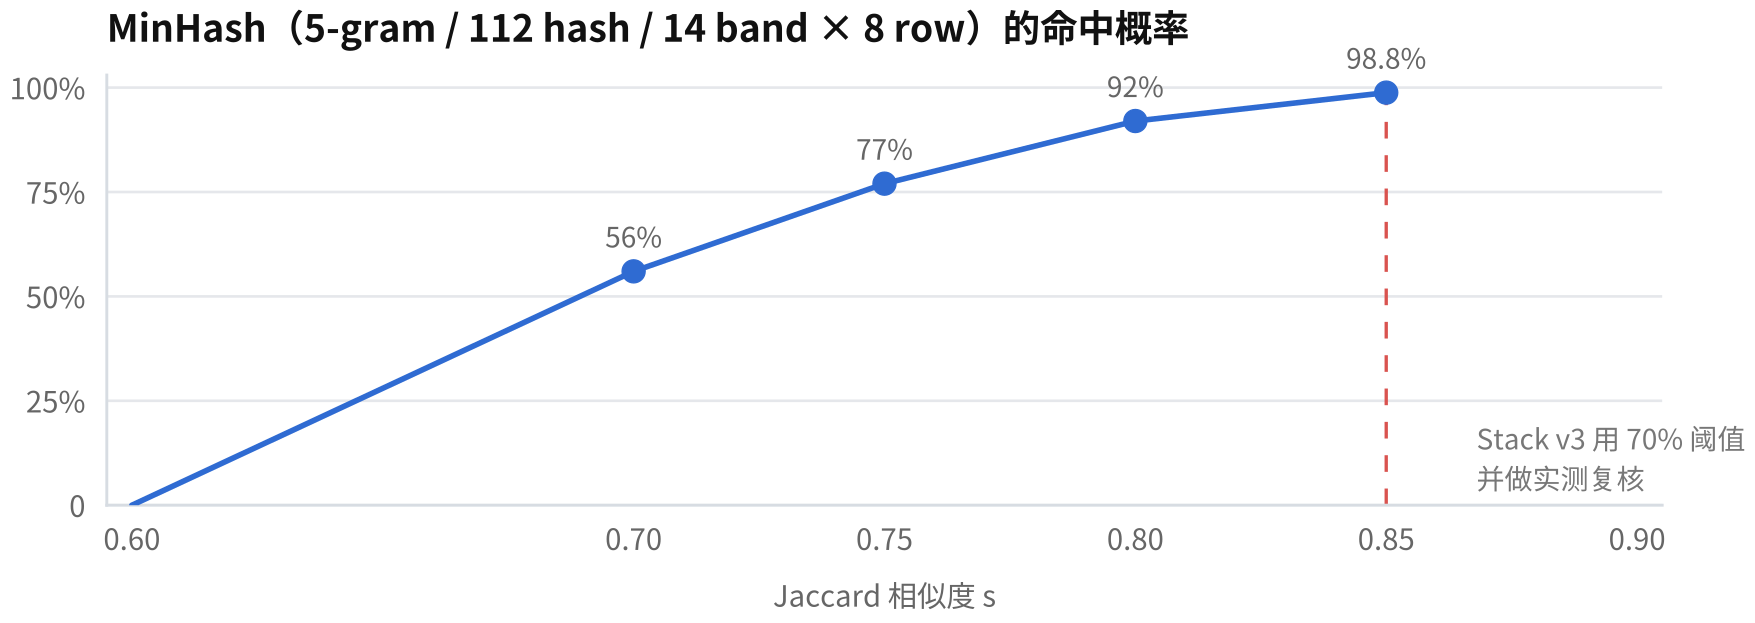
命中概率随相似度陡峭上升。这意味着阈值的选择比哈希函数的数量更敏感:从0.75提到 0.85,命中率从 77% 跳到98.8%,被判为重复的文件量差出一个量级。
太容易相似了
文件级去重与仓库上下文
仓库级训练希望保留文件关系,但只按整个仓库判重,容易漏掉局部重复。两个项目即使整体不同,也可能都复制了同一个依赖库。
OpenCoder 在 Python 数据上的对照显示,相同原始池中约有 4.858 亿文件和 1103 万仓库。文件级方案保留约3049万文件、32.74B tokens,仓库级方案保留约748万仓库、99.47B tokens,后者的token量约为前者三倍。 仓库级结果再做文件级去重,仍能删除约 68B tokens,即 68.4%;对应 1.5B 模型的 HumanEval/MBPP 实验中,文件级方案更好。[7,§6.1、表9、图8]
故此为了保持结构而牺牲去重,等于把去重作废。
这支持在该设置下优先控制文件冗余,但不能据此否定仓库上下文。我的处理思路是将内容存储、仓库版本关系和训练权重分开:相同正文共用存储,保留每个 repo/commit/path 关联,再控制训练时重复出现的次数。
其中,近重复文件不能任意替换成别的仓库代表,两个版本可能使用不同 API 或依赖。存储上只留一份,也不代表训练只用一次;如果打包时按一百个仓库关联展开,同一依赖仍可能出现一百次。
所以**文件去重与仓库组织应分别验收**。前者检查内容冗余,后者检查版本与依赖关系,最后还要检查实际训练曝光。即使只对部分内容计算 loss,重复上下文仍会消耗计算,并影响其他位置的预测。
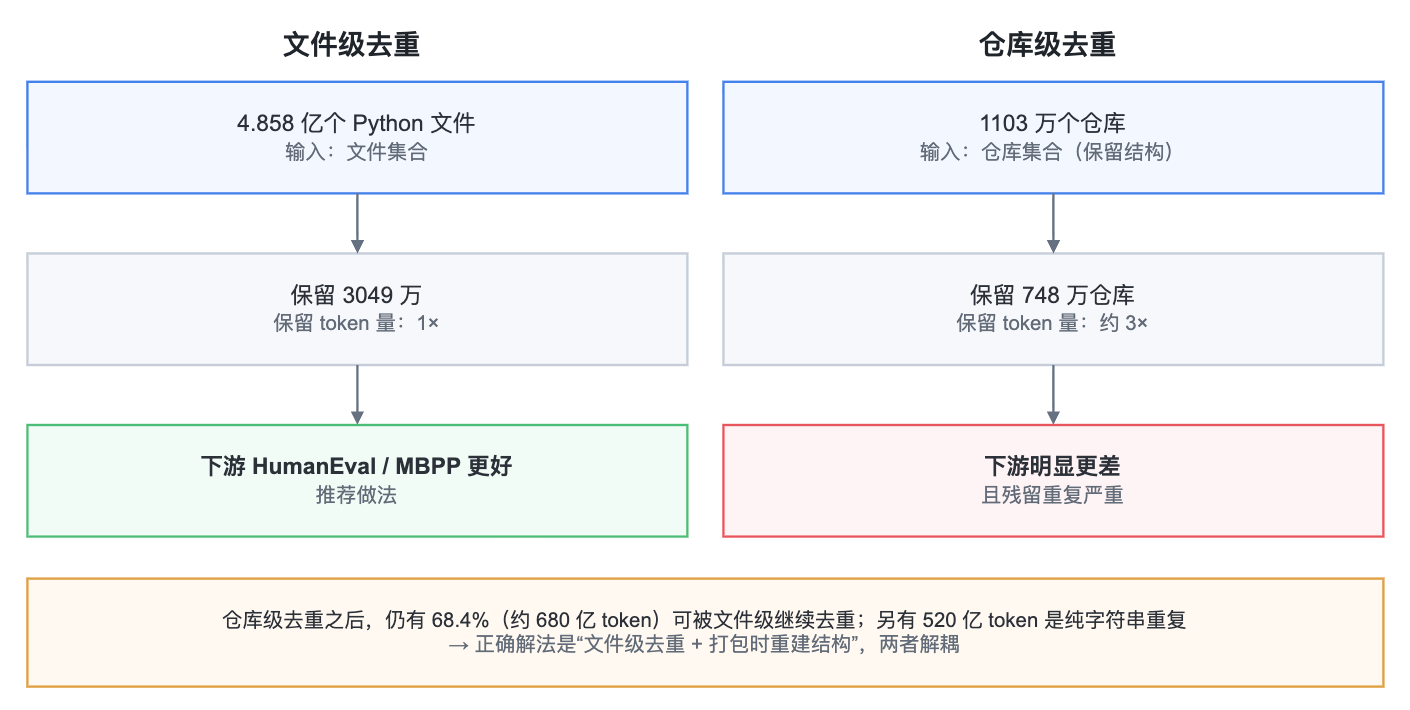
文件级完成去重后,在打包时再重建仓库结构,两者应该解耦。
去得越干净,一定越好吗?FineWeb 的答案是“不一定”
FineWeb 曾尝试跨全部 crawl 全局去重,老快照被删除大量内容;同预算训练下,效果却不如每快照独立去重。作者检查认为,正常的重复内容被削减后,广告和关键词列表等低质量内容可能被相对放大。 [8]
FineWeb2 则按自然语言跨快照去重,记录簇大小,再依据各类簇的质量过滤率分配重复权重,也就是 rehydration。[9] 它没有采用“N≥1000 一律删除”的固定规则,权重依赖具体语言和质量统计。
这些结果说明,去重与采样需要一起考虑。**减少偶然收录的重复,与有计划地重复高价值数据并不冲突。**关键是知道重复来自哪里,以及这样的重复是否改善了目标任务。
六、流程 2:规则过滤与模型评分
表面特征能判断什么
质量过滤是 2025-2026年变化最剧烈的地方。
2023-2024 年的主流是“人写规则“:StarCoder 的长行/字母占比/编码数据过滤, DeepSeek-Coder 的分语言规则,OpenCoder 的130+条手工规则带自定义权重ß。
2025年之后,头部团队不约而同地改成“用模型打分“。
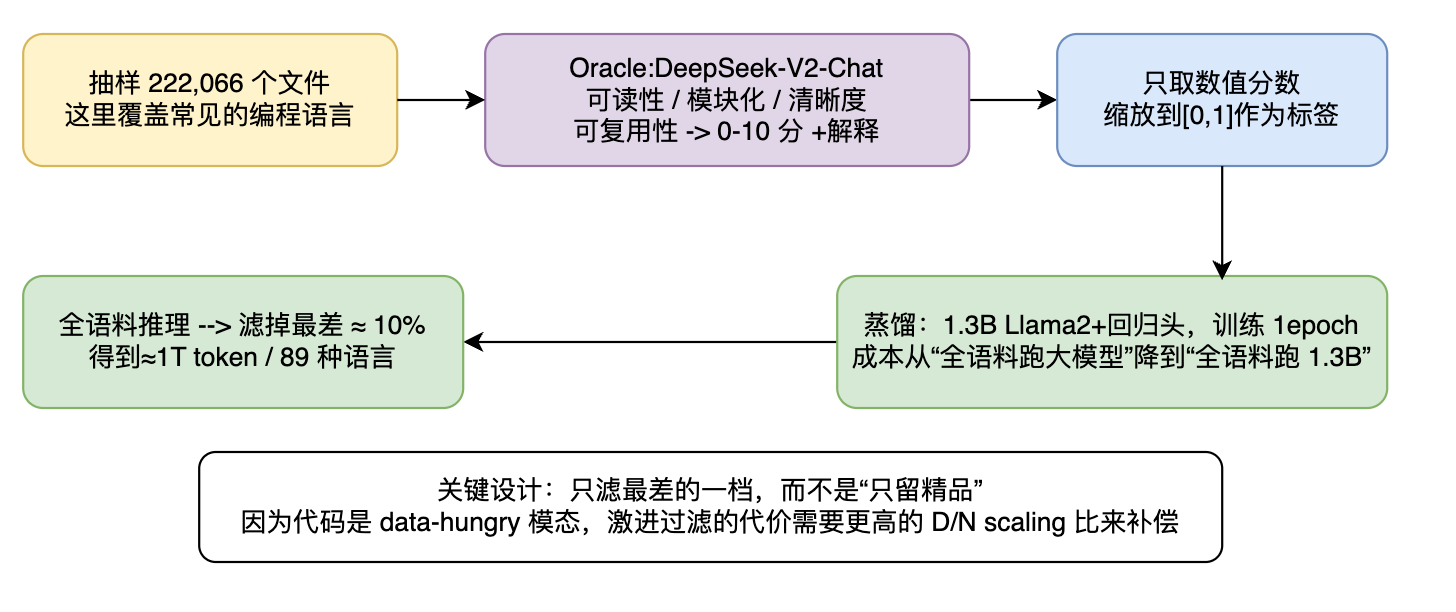
长行、乱码、明显的自动生成标记和大块编码数据,适合先用规则处理。这类方法成本较低,也便于解释排除原因。但格式特征与训练价值之间并不总是一致。[3][5][7]
Seed-Coder 的两个例子说明了这种局限。一个温度处理函数注释完整,却包含 temp < 0 and temp > 1 这样的不可能条件;另一个文件有大量硬编码数字,实际用于 LED 图案显示。[5]
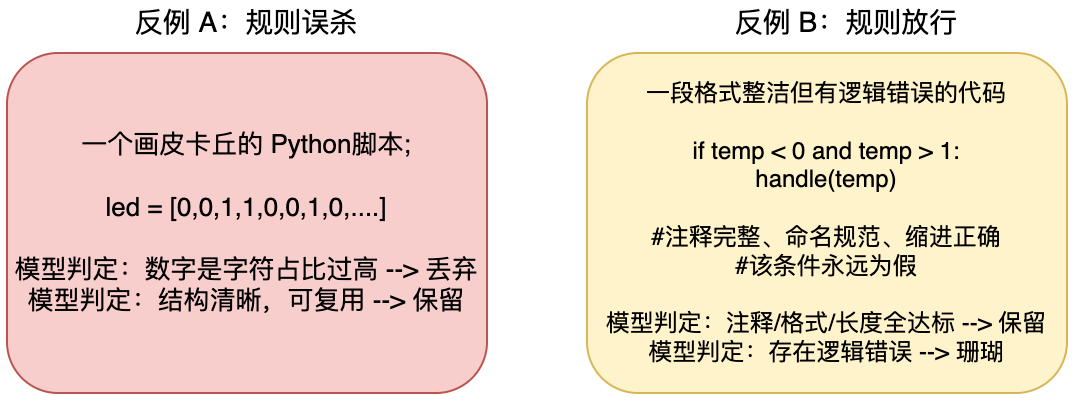
图中的“珊瑚“ = “删除”,笔误了,骚凹瑞
第一类错误可以通过约束分析或边界测试发现,困难在于为大量项目获得规格并完成验证。第二类内容则需要使用背景才能判断。模型评分可以补充这类软判断,但分数高仍不等于代码在所有输入下都正确。
Seed-Coder 的评分器和过滤比例
Seed-Coder 从常见语言抽取 222,066 个文件,让 DeepSeek-V2-Chat 按可读性、模块化、清晰度和可复用性评分。 分数归一化后,用一个 Llama 2 结构的 1.3B 预训练模型加回归头训练一轮,再对全量数据评分。[5]
后续步骤删除最低约 10% 的文件,得到约 1T unique tokens、89 种语言。 但在这之前,去重、基础处理和语法检查已经使原始数据体量减少约 98%。两阶段的统计单位也不同,不能直接相乘计算总保留率。[5,§2.2.1]
因此,10% 描述的是预处理后文件的质量筛选强度,并非原始 GitHub 数据的总删除率。复制这个比例之前,需要先确认自己的前处理和语料分布是否相近。
评分器本身也会有来源偏好。Seed-Coder 发现,网页评分容易偏爱格式整齐的电商、颜色页面和文档,而低估形式杂乱的论坛内容,因此需要分类别调整阈值与采样。 [5,§2.2.3] 减少手工规则并没有消除目标定义、标签选择和类别划分对结果的影响。
Stack-Edu 和 MIRA 的不同目标
Stack-Edu 更关注教育性。它从 StarCoder2Data 的 15 种主要语言中,用 Llama3-70B-Instruct 生成教育评分,再训练 15 个语言专用 StarEncoder 分类器,每个使用 50 万样本。约 450B tokens 中最终保留约 125B,即约 28%。[10]
这个比例无法与 Seed-Coder 保留约九成预处理后文件直接比较:筛选目标、数据分布、统计分母和训练阶段都不同。SmolLM2 的相关消融从已经训练 3T tokens 的检查点出发,再进行 200B-token annealing;Python HumanEval 从 20.7 提升到 25.6,C++ MultiPL-E 从 16.7 提升到 24.8。[10,表2]
MIRA 进一步按数据来源定义 rubric,再进行教师打分、学生蒸馏和组内选择。Qwen2.5-Coder-14B 的实验中,25B-token MIRA-Group 的四类任务宏平均为 64.20,50B raw mixture 为 63.83;SWE-Multi 则是 36.33 对 40.00,仍然下降。[11,表1]
所以 “半量追平”只适用于该宏平均和后续统一 SFT 设置。教师标注、评分器训练和全量推理仍有成本,个别任务也未追平。MIRA-Global 不如同预算随机选择的结果,则提示不同来源的分数需要校准,不能直接共用一个阈值。
评分器的验收
- 在确定评分器规模之前,我会先检查标签和筛选结果。人工抽查与执行校准应覆盖低资源语言、长文件、配置文件,以及格式不规范但有用的代码;学生误差则要按来源、语言和评分档拆开看,避免多数中高分样本掩盖低分尾部的失败。
- 筛选后还要统计语言、库、任务、长度和年代的变化。模型评分可能提高某类样本的比例,也可能让整个数据分布变窄。实验上至少保留无评分基线、来源保持的随机筛选和来源内评分筛选,同时报告 unique tokens 与重复次数。[5][10][11]
- 语法检查同样需要分桶。Tree-sitter 解析成功不等于编译成功,错误恢复得到的树也不代表语法合法;解析失败则可能来自不支持的新语法或 DSL。将这些情况单独记录,才有机会判断是样本问题还是工具覆盖不足。
快速记忆:
- 标签可靠吗? 人工抽查与执行校准是否覆盖低资源语言、长文件、合法配置和不漂亮但有用的代码?
- 学生真的学到尾部了吗? 总体误差很好,可能只是多数样本集中在中高分;应看来源、语言和评分档的误差。
- 筛完以后分布变了什么? 语言、库、任务、长度和时代分布有没有被顺手洗窄?
- 同预算有没有更好? 至少比无评分基线、来源保持的随机筛选、来源内评分筛选;同时报 unique tokens 与重复次数。
这一节的结论是: “质量”不是样本固有的单个分数,而是样本、目标、上下文和预算之间的关系。 [5][10][11]
七、流程 3:从 commit、PR 和 issue 构造训练数据
仓库快照记录某个时刻的代码,演化记录补充了代码如何变化。commit 和 PR 通常保留最终提交,却不完整记录失败尝试、临时搜索和被放弃的方案。 因此,这类数据更适合用来重建意图、修改前代码、变更和验证结果之间的关系,不能直接视为完整的人类推理轨迹。
静态仓库是软件开发的终态:它记录了结果,却丢掉了规划、调试、返工、重构的过程。2025- 2026年最有价值的新数据源,几乎都来自“把过程找回来“。主要是:commit/PR/issue(重建) —— 的“过程数据” 。
commit:变更预测
2023 年的 OctoPack/CommitPack 已将 commit message 与代码变化用于 instruction tuning,CommitPackFT 则进一步选择更像自然语言指令的消息。[12] 这类监督不需要每次重新编写需求,但消息质量差异很大;只有“fix”或“update”的记录,能提供的信息有限。
Seed-Coder 将它用于持续预训练:从 140K 个筛选仓库收集 74M commits,仓库门槛包括至少 100 stars、10 forks、100 次提交和 100 天维护活动。去重与预处理后,得到约 100B-token 语料。[5,§2.2.2]
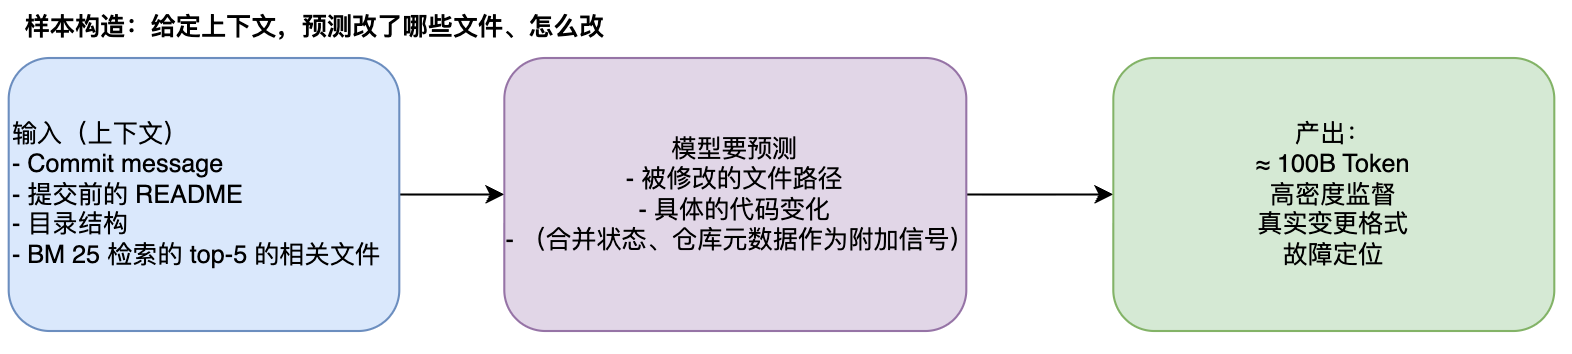
输入包括 commit message、变更前 README、目录结构和 BM25 检索的五个相关文件,目标是修改路径与代码变化。这比静态续写更接近定位和编辑任务。不过,论文没有提供只改变 commit 数据、其他条件不变的完整消融,最终 SWE 成绩不能单独归因于这一项。
PR:编辑表示与往返重建
PR 通常还带有描述、评审和关联 issue。Clean-PR 从约 1640 万条原始 PR、8.6 TB 数据和 27.4 万个仓库出发,过滤后约 18.59% 进入初步清洗集;进一步约束修改范围、长度和仓库采样后,形成约 202 万个训练实例、17.7B tokens,覆盖 12 种语言。[13,表2–4]
这里的单位是 PR 实例,每个实例平均含 4.3 个 Search/Replace blocks。未被选入的记录也不能一概称为噪声:不符合当前编辑任务的筛选要求,与没有其他训练价值,是不同判断。
Clean-PR 将原始 diff 转换为 Search/Replace 表示,再将它应用回 before 文件,要求结果与目标 after 逐字节一致。验证同时要求 SEARCH 唯一、多个修改区域不重叠。[13,附录A.4]
注意计数单位:不是 202 万个编辑块;一个训练实例平均包含 4.3 个 Search/Replace blocks。
Clean-PR 的核心工程动作是往返重建:
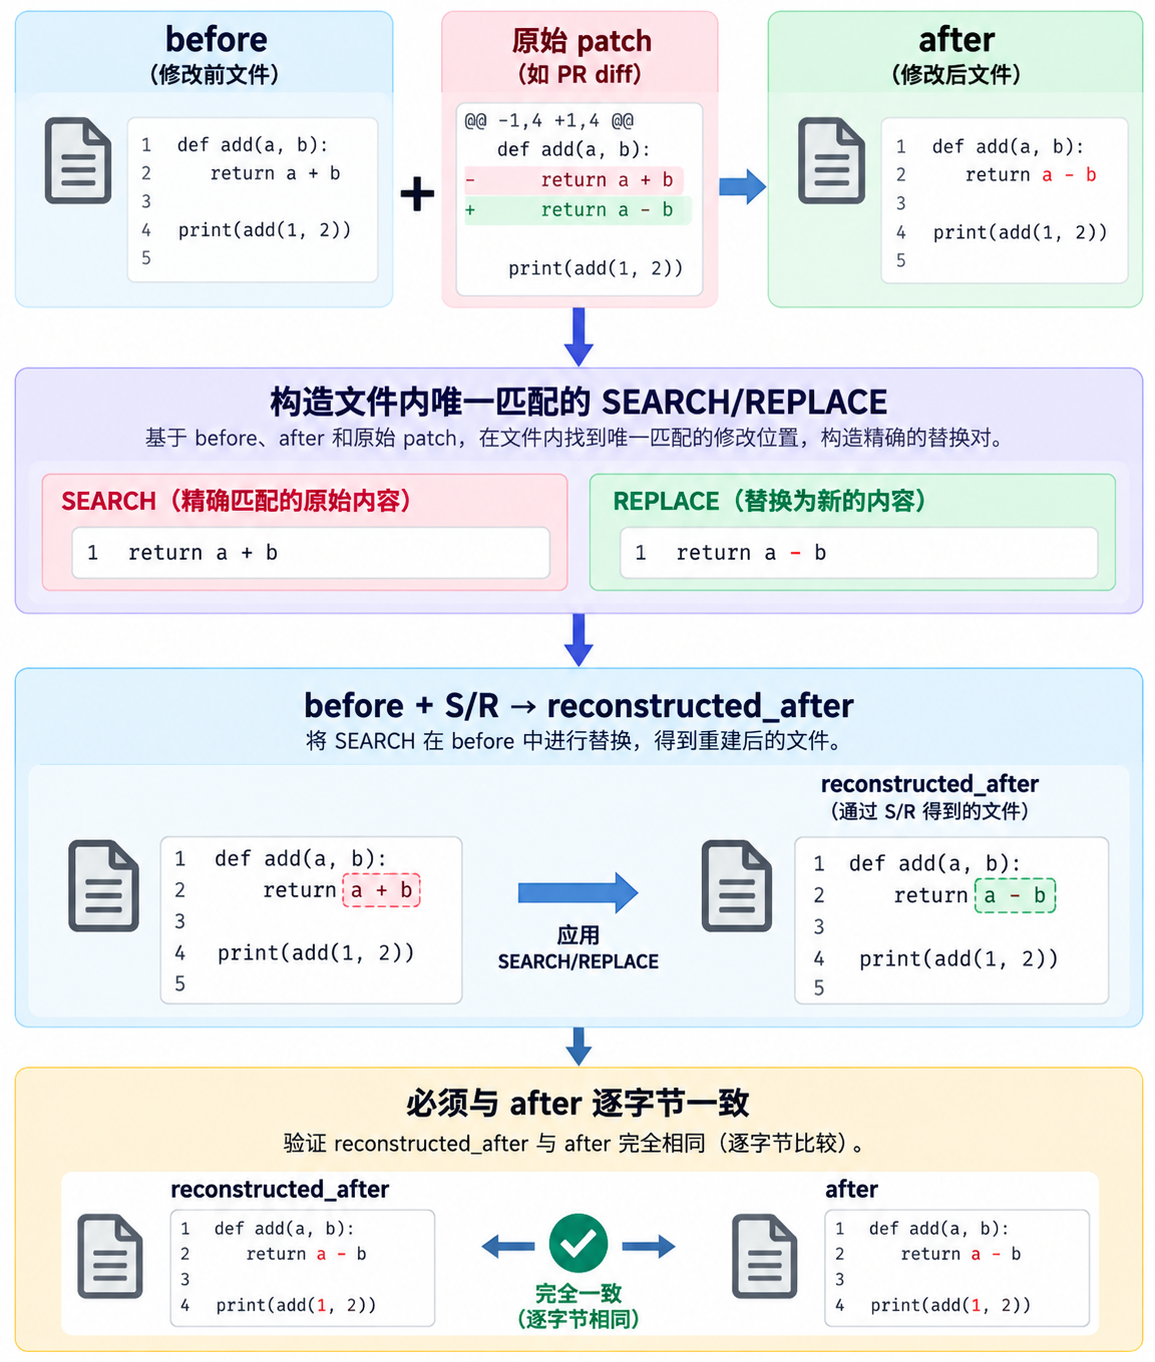
图中把加法改成减法,只用于说明两种编辑表示能否得到相同文件,不是在判断哪一种运算符合需求。这也正是往返重建的范围:它保证编辑目标能够重放,不能单独证明项目可编译、测试通过或原始修复正确。
简言而之:格式有效、行为验证、评测独立。
编辑 mid-training 与后续 SFT
PR数据的最佳落点是 mid-training,不是 SFT
Clean-PR 先做编辑数据 mid-training,再用文件定位、细粒度定位和补丁生成等分步骤样本做 SFT,并加入错误检索产生的干扰上下文。[13] 这些样本用于训练模型区分真正需要修改的内容和无关文件。
论文在 Qwen2.5-Coder-32B 与简化 Agentless 协议下报告:[13,表6]
| 训练条件 | SWE-bench Lite pass@1 | Verified pass@1 |
|---|---|---|
| 原 Qwen-Coder-32B-Instruct | 10.7% | 18.3% |
| Base + 本文 SFT,无 mid-training | 11.3% | 17.6% |
| Base + StarCoder2-style 17.4B + SFT | 15.7% | 20.4% |
| Base + Clean-PR 17.7B + SFT | 24.3% | 30.6% |
相对第一行,提升为 13.6 和 12.3 个百分点。这是两阶段训练的组合结果;17.7B 是语料规模,mid-training 跑两轮,也不能直接用它表示累计训练量。
Python 条件下,论文还比较了只用 PR 描述与增加关联 issue 的效果:Lite 从 20.4 到 22.3,Verified 从 25.7 到 27.8。[13,表8] 这个消融说明 issue 提供了额外上下文,同时也表明 PR 描述本身能够形成有效监督。
issue 与训练样本的形态
唯一把“需求”和“代码变更“配上对的天然语料
Issue 通常包含用户侧的复现步骤、报错、期望行为和澄清讨论,有助于补全 PR 描述里省略的需求条件。commit message、PR title/body 和 review 也可以解释修改原因;软件工程题面还可能由 commit 回译或任务合成得到。[12][13][17]
Issue 的优势通常是用户视角:复现步骤、异常日志、期望行为以及维护者的追问。它能补上开发者一句“修复边界情况”背后到底是哪种边界。
在组织数据时,我更愿意按训练产品分类,而不是直接用 GitHub 对象类型决定训练阶段:
| 训练产品 | 内容 | 最低需要验证什么 |
|---|---|---|
| 编辑样本 | 描述 + before + edits | 能忠实重建目标状态 |
| 可执行任务 | 题面 + 基线环境 + 隐藏测试 | 任务可运行、测试有效、规定范围内无回归 |
| 交互轨迹 | 观察、定位、编辑、工具调用与反馈 | 终态结果、过程记录与模仿目标有效 |
三类产品都可以使用 commit、PR 和 issue。是否适合 CPT、编辑 SFT、agent SFT 或 RL,要结合样本组织方式和训练目的判断。
从真实任务到合成环境:SWE-Gym、SWE-smith 与 SWE-Mirror
SWE-Gym 为真实历史问题配置环境和测试,SWE-smith 在可运行仓库中注入缺陷,R2E-Gym 从 commits 回译题面并收集或生成测试。[15][17][41] 相比静态编辑样本,这些工作增加了环境和反馈,可以继续采集求解轨迹。环境构建的更多细节见另一篇文章:基模杂谈swe-环境构建与长程轨迹挖掘。
更全面的 Agent 打镜像的过程,可以参考文章:基模杂谈swe-环境构建与长程轨迹挖掘
SWE-Mirror 复用已有环境,将真实问题的核心逻辑移植到相似目标仓库,再生成相应缺陷、测试和题面。[18]
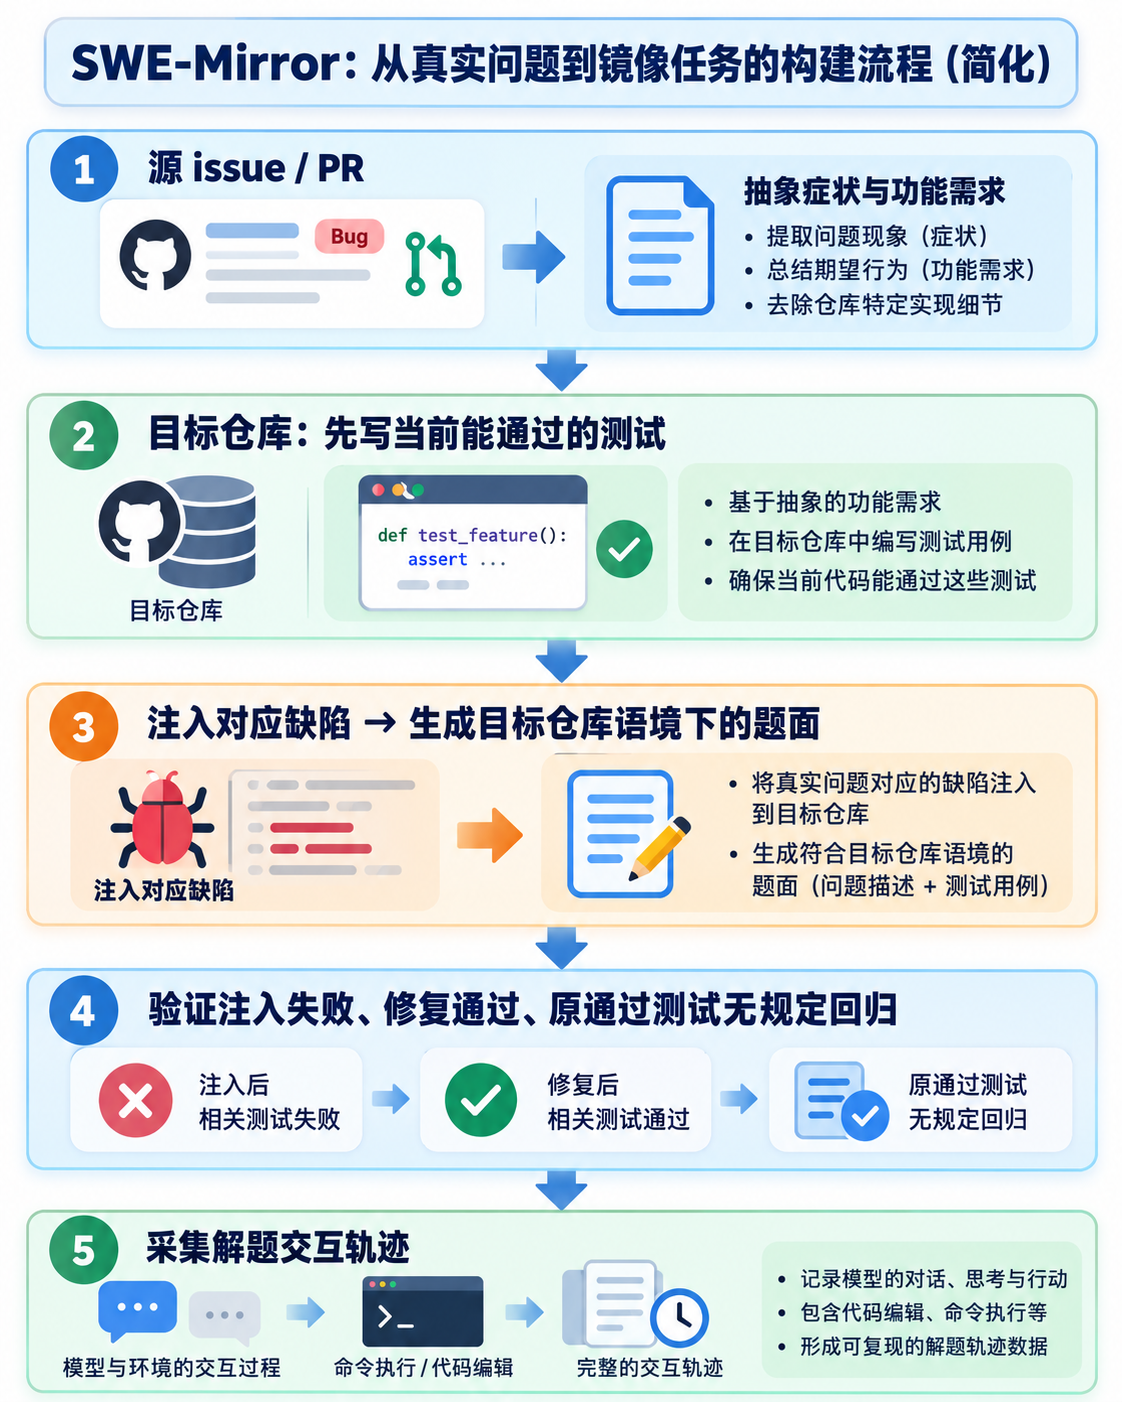
这张简图将题目和测试画在同一构建流程中;训练产品仍需区分模型可见的题面与隐藏测试。注入缺陷后,应当观察到相关测试失败,修复后再检查通过与回归情况。
论文报告 60,671 个验证任务。这些任务有真实问题来源,但移植后的缺陷不一定在目标仓库历史中发生过,因此包含合成成分。最强 32B 模型使用 12,456 条 SFT 轨迹,其中 6,431 来自 Mirror,6,025 来自 SWE-rebench。在其框架、轮数和上下文设置下,Verified 从 6.2% 到 52.2%,提升 46.0 个百分点。[18,§3、表6]
这组收益来自混合轨迹和完整训练方案,无法单独归因于验证器。 测试验证本身也有边界:除 F2P 和回归检查外,作者检查异常与 flaky 状态,并对一小批任务做语义审核;通过执行检查的镜像任务,仍不全都与源问题一致。[18,§2.4]
因此,编辑重建、执行验证和语义一致性应分别记录。任务数、轨迹数、编辑块数和 token 数,也对应不同成本与覆盖范围。
执行环境还涉及安全和复现。 安装脚本、测试及依赖来自不可信代码,不应直接在带生产凭据的宿主机运行。建议使用可销毁、最小权限、受限网络和资源配额的环境,固定镜像摘要、base commit、依赖来源和测试命令,并保留失败日志。 容器本身不能保证安全或复现;未锁定的依赖和外部服务仍会影响运行结果。
小结:三者对照
commit 和PR是语料,issue 是题库。
- 把issue 当语料喂,你得到的是1%的权重、80%+ 的噪声,外加一份可能污染你所有 SWE 评测的答案纸;
- 把issue 当题面用,配上“‘gold patch使 F2P ≠ 0且 P2F=0“ 这类硬验证,它就是目前最便宜的真实任务来源——SWE-Mirror 的+46.0% 就是这么来的。区别不在数据,在于你有没有验证器;
八、流程 4:合成数据的用途与风险
合成代码常被分成改写、教科书或练习、执行验证几类。实际管线可以组合这些方式:从真实代码出发,补充解释,生成测试,执行修复,再用于训练。[14][19][21][22]
| 路线 | 主要解决的问题 | 最容易引入的偏差 |
|---|---|---|
| 改写型 | 可读性、冗余、自包含性与表达噪声 | 接口漂移、过度规范化、抹掉真实依赖 |
| 教科书/练习型 | 概念讲解、示例密度与难度组织 | 风格单一、题型窄、远离工程长尾 |
| 执行验证型 | 实现与测试是否一致、修复能否闭环 | 测试 oracle 错误、易验证任务偏好、环境成本 |
它们解决的问题不同,评价时应先明确希望改善哪种能力,再比较数据和验证成本。
SwallowCode:改写与规格保持
SwallowCode 来自 The Stack v2 的 Python 子集,最终约 16.1B tokens,并公开了数据、prompt、管线与模型检查点。 其 transform-and-retain 思路,是对通过基础检查的代码继续改写,而非只保留少量高分样本。[19]
具体流程仍包含过滤:先做 Python 语法检查、pylint 和注释规则处理,再进行 SGCR 与 SCOR。SGCR 按风格指南调整命名、结构和表达,SCOR 改善自包含性、冗余和实现细节。因而这项工作结合了筛选和改写,两者并不互斥。
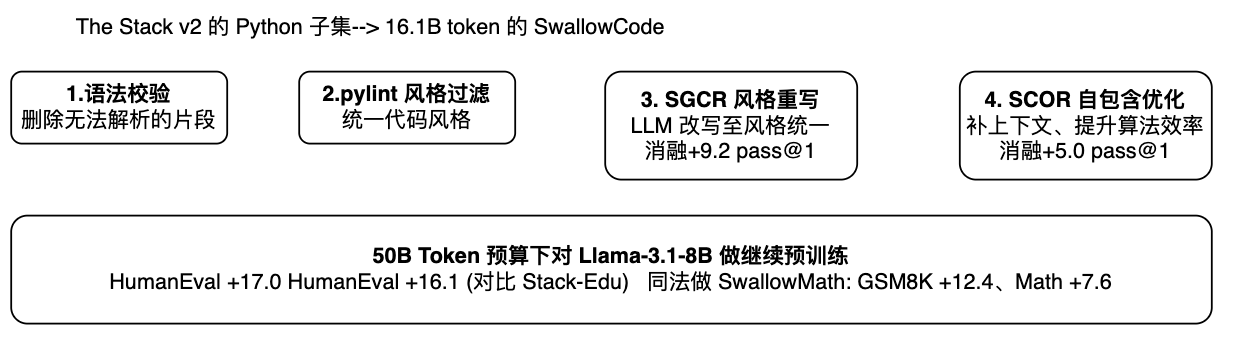
主实验以 Llama-3.1-8B 进行 50B tokens 的持续预训练,其中代码占 16%,即 8B tokens,其余为多语言文本。在相同预算下,相对 Stack-Edu 条件,HumanEval 提升 17.0 个百分点,HumanEval+ 提升 16.1 个百分点。[19,§3]
论文也报告了负结果:SGCR 后 MBPP 下降约 10 个点。作者认为,模型学到了规范命名的偏好,会把题目指定的函数名改为 snake_case,导致测试找不到原接口。[19,§3.3.1、附录I]
这个失败需要作为改写验收的一部分保留下来。 可读性、自包含性和冗余可以改善,但函数签名、API 与行为约束是否保持,是另一项检查。如果目标是保留原规格,改写后就应单独验证这些条件,不能只看风格评分。
SGCR: 按风格指南重写命名、结构与表达
- 命名更规范
- 结构更清晰
- 表达更一致
SCOR: 改善自包含性、冗余与实现
- 提升自包含性
- 减少冗余
- 优化实现细节
Phi-1:真实代码、教材和练习的组合
Phi-1 的预训练数据包括约 6B tokens 的筛选真实代码与 StackOverflow 内容,以及不足 1B tokens 的合成 Python 教材;之后再用约 180M tokens 的合成编程练习微调。[14]
它的 base 在 HumanEval 上约为 29%,后续练习微调后达到 50.6%。因此,最终成绩涉及多个阶段:筛选真实语料、组织教学内容和练习式微调,不能全部归到合成教材一项。
教材数据能将概念、解释、代码示例和典型用法组织在一起,便于模型建立知识关联。但它通常偏向清晰、自包含的例子,对稀有 API、历史兼容、跨模块依赖和不规则边界情况覆盖较少。使用这类数据时,我会同时检查教学任务的收益与真实工程分布的保留情况。
合成比例与训练效率
《Demystifying Synthetic Data in LLM Pre-training》研究英文网页与改写、问答、教科书式合成数据的混合,实训规模到 3B 参数、200B tokens,主要指标是验证损失。[20]
在其部分较大预算设置中,约三分之一改写数据与三分之二真实网页的混合,可以用更少训练量达到相近验证损失。 论文的“5–10×”来自 scaling 结果和外推,描述训练样本效率潜力;它不表示 GPU 吞吐提高相同倍数,也没有计入生成、验证和失败重试后的全部成本。
同文中,33% 教科书混合优于 67%,而 Phi-4 又使用较高的合成与重写比例。 [20][23] 两者的原料、教师、处理方式、模型预算与评价目标不同,不能仅根据“合成比例”判断哪种结果更普遍。该网页研究的精细比例实验与正文“约30%较优”的概括还有不完全一致之处,缺少原始 run 表时,不适合直接将其作为通用最优点。
测试验证与测试质量
UnitCoder 将代码提取、测试生成、执行修复和解释性改写串起来;KodCode 同时生成问题、解答与测试,结合执行结果和分支覆盖筛选。[21][22] 这些实验主要发生在后训练阶段,说明验证与改写可以组合,但不能直接确定预训练中的合成比例。
验证还需要可靠的 test oracle。100% branch coverage 表示测试覆盖了全部分支,不代表测试表达了正确需求。例如,没有分支的 return x + 1 很容易达到满覆盖;如果需求是 x + 2,答案和测试又恰好采用了同一个错误理解,它们仍可能一起通过。
UnitCoder 还说明,其测试生成器使用 BigCodeBench 函数与测试训练,随后又用 BigCodeBench 评估下游模型。[21,§4.1] 屏蔽输入函数的 loss 不能证明生成器没有接触评测信息。这里无法量化它影响了多少分,但去污染范围显然需要覆盖 teacher、verifier、测试生成器和种子,而不仅是最终训练集。
因此,我会分别记录执行通过率、测试 oracle 可靠性、覆盖率、误杀与漏检、接口保持率,以及原始代码、改写和测试之间的血缘关系。单一的“通过/失败”字段不足以说明数据质量。
递归训练与模型坍塌
模型坍塌研究关注多代模型使用前代生成数据时的变化。如果每代都用合成数据替换原始数据,生成误差可能累积,低概率和长尾模式也容易丢失;保留部分真实数据可以减轻相应退化。[24]
后续研究进一步区分替换、混合和历史累积。在所研究的设置中,保留初始数据并累积历代合成数据可以维持较稳定的表现;若总训练数据量固定,只从不断扩大的历史池中抽取有限子集,仍可能出现较慢的退化。[25] 累积方案还可能增加存储与训练计算量,需要与固定预算方案分别比较。
因此,单轮合成混合的结果不能直接回答长期递归训练的问题。管线应记录初始来源是否保留、合成样本来自哪代模型、各代如何混合,并持续检查长尾能力。
九、流程 5:仓库组织与长上下文
仓库级训练包含几个相关但不同的变量:选入哪些内容、怎样排列,以及模型是否适应更长的位置跨度。许多配方同时改变这些条件,解释收益时应尽量拆开。
一般采用拓扑拼接,但仓库内的拼接策略可能被高估了
Granite 的组合方案
IBM 在 Scaling Granite Code Models to 128K Context(arXiv 2407.13739)里给出了目前最完整的配方:用import建 DAG –> 破环 –> 拓扑排序,文档与构建文件置顶、依赖文件次之、 非连通文件按目录树 DFS 排列;<4096 token 的文件降采样到 10%;RoPE $\theta$ 从8K/100K阶梯升到 128K/10M。只花 4B token(原预训练的 0.1%),长上下文任务最高+38%,短上下文只掉约1%。这套配方已开源为 IBM data-prep-kit 的 repo_level_ordering 变换(可在 SORT_BY_PATH 与 SORT_SEMANTIC 间切换)。
Scaling Granite Code Models to 128K Context 的扩窗方案基于已有 3B/8B 代码模型。作者根据 import 关系建立有向依赖图,处理环后得到 DAG,再拓扑排序;文档和构建文件优先,不连通文件结合目录遍历安排。 训练还将短于4096 tokens的文档降采样到10%,并逐步调整窗口与RoPE基频参数,例如从8K窗口、theta为100K,扩展到128K窗口、theta为10M。[26] 这些是该论文的配置,不能将窗口长度与theta当成同一个量。
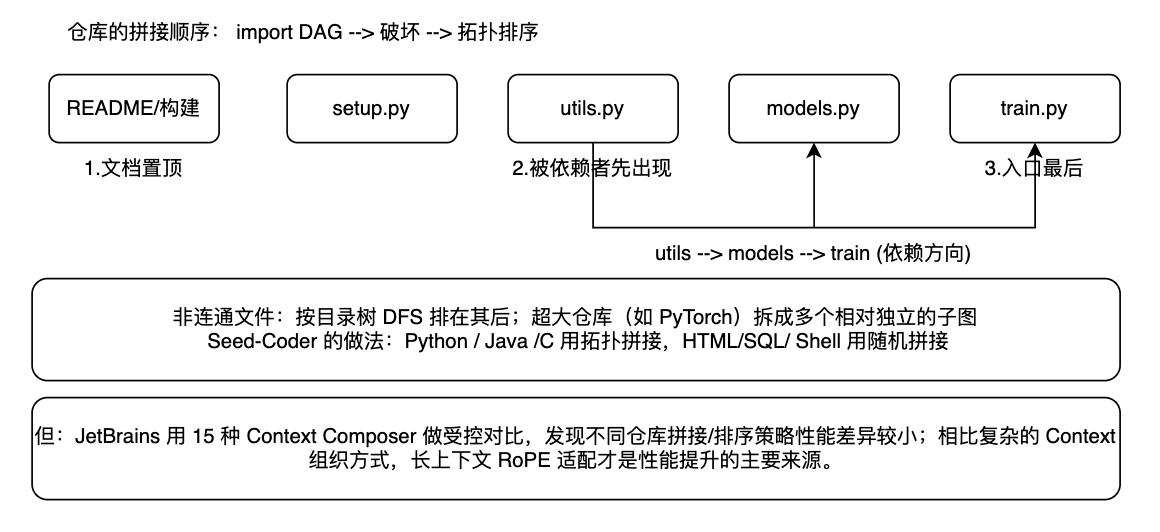
拓扑拼接是工程上合理的默认,但别指望它带来质变。真正决定长上下文效果的是位置编码的扩展方式。不同的拼接策略收益几乎一样,主要收益来自 RoPE ABF ($\theta$ 1e4 –> 5e5),且只用了1B token(实际有效72M)就追平数百 B token 的竞品。
论文额外使用约 4B tokens,约为原预训练数据量的0.1%。这个比例描述 token 量,不能直接换算成 GPU 时间或 FLOPs 占比。RepoQA 上的收益也来自仓库组织、长度重采样和位置适配的组合,无法单凭主结果确定某一项贡献。[26]
官方 data-prep-kit 提供 repo_level_order 变换,支持路径、语义等组织方式。[31] 在复用时,应记录输入结构、排序规则、长度分布与位置参数,再通过对照判断哪些处理必要。
项目级补全中的位置适配
《On Pretraining for Project-Level Code Completion》在 OpenCoder-1.5B 上研究 Python 单行补全,将窗口从4K扩到16K,并比较多种 composer。[27] 在统一推理布局下,file-level 数据配合 RoPE 适配训练的 inproject EM 为45.2,Path Distance 仓库组织为48.8;仅修改 theta 而不训练时为9.8。[27,表3]
论文系统比较了 15 种 repository context composer,即不同的仓库级上下文构造/拼接策略。
比较的策略不只是简单的“文件排序”,而是包括例如:
- File-level:完全不加入跨文件 repository context,作为单文件 baseline;
- Path Distance .py:按目录/路径距离排序,再用代码行 IoU 做次级排序;
- Lines IoU .py:仅按代码内容相似度 IoU 排序;
- Code Chunks:在 Path Distance 的基础上去掉 docstring、comments、imports;
- Half-memory .py:随机 dropout 约 50% 的 context 行;
- Declarations .py:只保留函数、类等声明;
- 另外还有 reversed、irrelevant 等人为扰动版本,用来研究顺序和噪声的影响。
具体来说,他们把 OpenCoder-1.5B 的上下文从 4K 扩展到 16K,比较不同 composer 后,在
inproject 上各 repository-level composer 的 Exact Match 大约在 45.2–48.8 之间,最好与最简单策略只差约 3.6 个点。甚至 File-level + RoPE 长上下文适配 本身就已经达到很强的结果,因此作者认为 RoPE adaptation 是主要驱动因素,context composition 本身的贡献相对次要。
该文比较的15类上下文构造方式不只涉及排序,还包括文件和片段选择:Path Distance 按路径距离组织,Lines IoU 按代码重叠程度选择;Code Chunks 去掉 docstring、comments 和 imports;Half-memory 随机丢弃约50%的上下文行;Declarations 只保留声明;另有 reversed、irrelevant 等扰动。[27]
这些结果表明,位置适配训练提供了很大一部分收益,正常代码组织方式之间的额外差距相对有限。因而可以先建立 file-level 加长上下文适配的基线,再判断依赖和仓库组织的增量价值。这里的结论仍限于该模型与补全任务。
成本比较也要保留已有基座这一前提。论文脚注中的72M tokens属于一个特定 file-level 对照,并非所有仓库级实验的训练量,也未包含 OpenCoder 之前的预训练。[27]
此外,训练 composer 和推理 composer 应分别控制。统一推理布局下,一些训练扰动影响不大;若推理本身使用干扰布局,性能却会下降。[27] 训练排序差距有限,不能推出推理检索和上下文选择不重要。
OctoLong 的跨仓库依赖
OctoLong 使用 AST、语言服务器和包管理器递归追踪跨仓库依赖,将调用点需要的定义、包实现及相关逻辑放进上下文。[28] 它研究的重点是内容关联,而非只调整已有文件的排列。
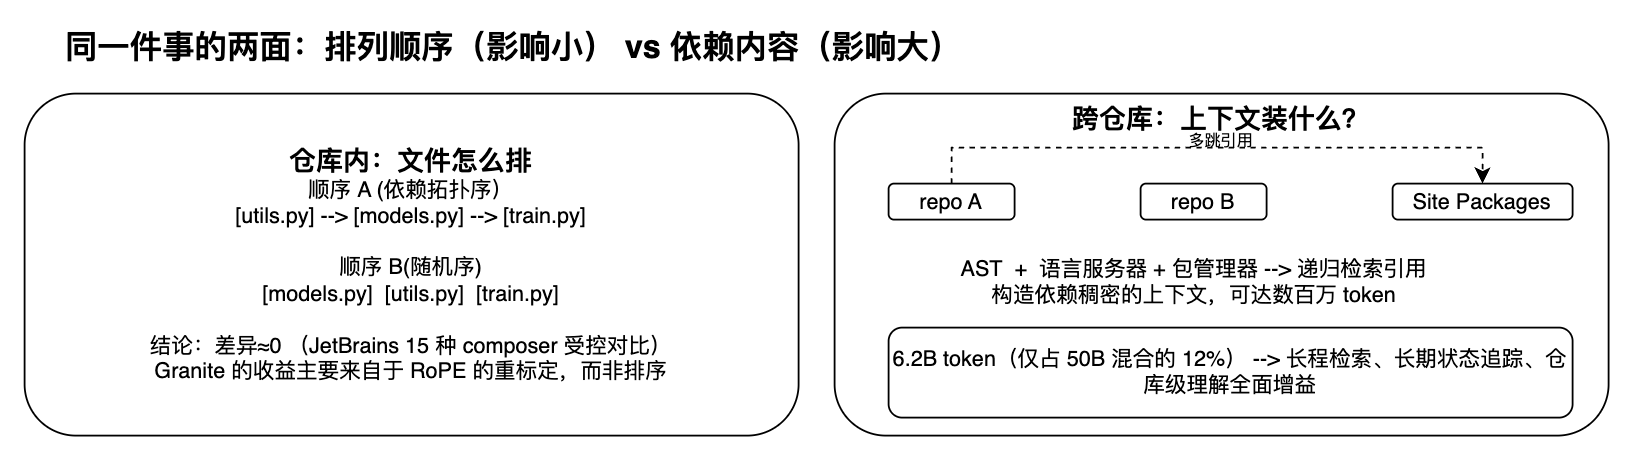
采集主要围绕 Python 展开。虽然能够构造百万 token 甚至更长的依赖上下文,论文主要训练窗口仍为128K。完整流程包括约50B tokens的长上下文阶段,其中约6.2B来自跨仓库代码,之后还有模型合并和约10B tokens的SFT。[28]
“约12%跨仓库数据”因此是50B阶段内部的份额,不是整个流程的成本比例。8B等规模替换实验中,将跨仓库数据换成规模匹配的控制语料后,多项长程任务和部分短代码指标回退,支持依赖相关内容的增量价值。与官方Qwen3-8B相比,完整模型部分pass@1仍较低,效果并非覆盖所有指标。[28,表4、附录表9]
结合前面的补全实验,我会先完成位置适配,再比较相关内容与依赖密度,最后优化排序。 这样可以避免为了较小的排序收益,提前承担复杂的解析与构图成本。
十、流程 6:FIM 的数据变换与掩码选择
Fill-in-the-Middle 将代码切成 prefix、middle 和 suffix,再重新排列,使模型利用两侧上下文恢复中间内容。训练仍可使用自回归 next-token prediction,无需因此更换模型架构。[29]
| |
实际模型还会使用专门的 sentinel token。上面只描述内容顺序,具体模板必须与模型兼容。下面是一个 PSM 示意:
1 2 3 4 5 6<fim_prefix> def add(a, b): <fim_suffix> a + b <fim_middle> return
FIM rate 与切分方式
FIM rate 通常表示样本被转换为 FIM 的概率。 0.5 表示约一半样本使用这种形式,而非每个文件都挖掉50%内容。PSM/SPM比例、切分单位、跨度长度、随机与结构掩码比例、loss位置和启用阶段,都需要另外定义。
原始FIM工作先按字符位置切分,再分别tokenize,因此边界可以位于词或原token内部。这里的字符级描述切分方式,不表示模型采用字符词表。论文同时保留prefix、suffix、middle的loss,并建议混合PSM与SPM。[29]
在其特定模型和预算下,rate升到0.9未明显损伤左到右建模,1.0出现退化。Seed-Coder则在regular阶段使用0.5、continued阶段降到0.1,并采用SPM;DeepSeek-Coder和StarCoder也有各自的排列配方。[5][29][33] 这些结果可以作为实验起点,不能据此规定所有模型的安全阈值。
结构化与随机缺口的组合
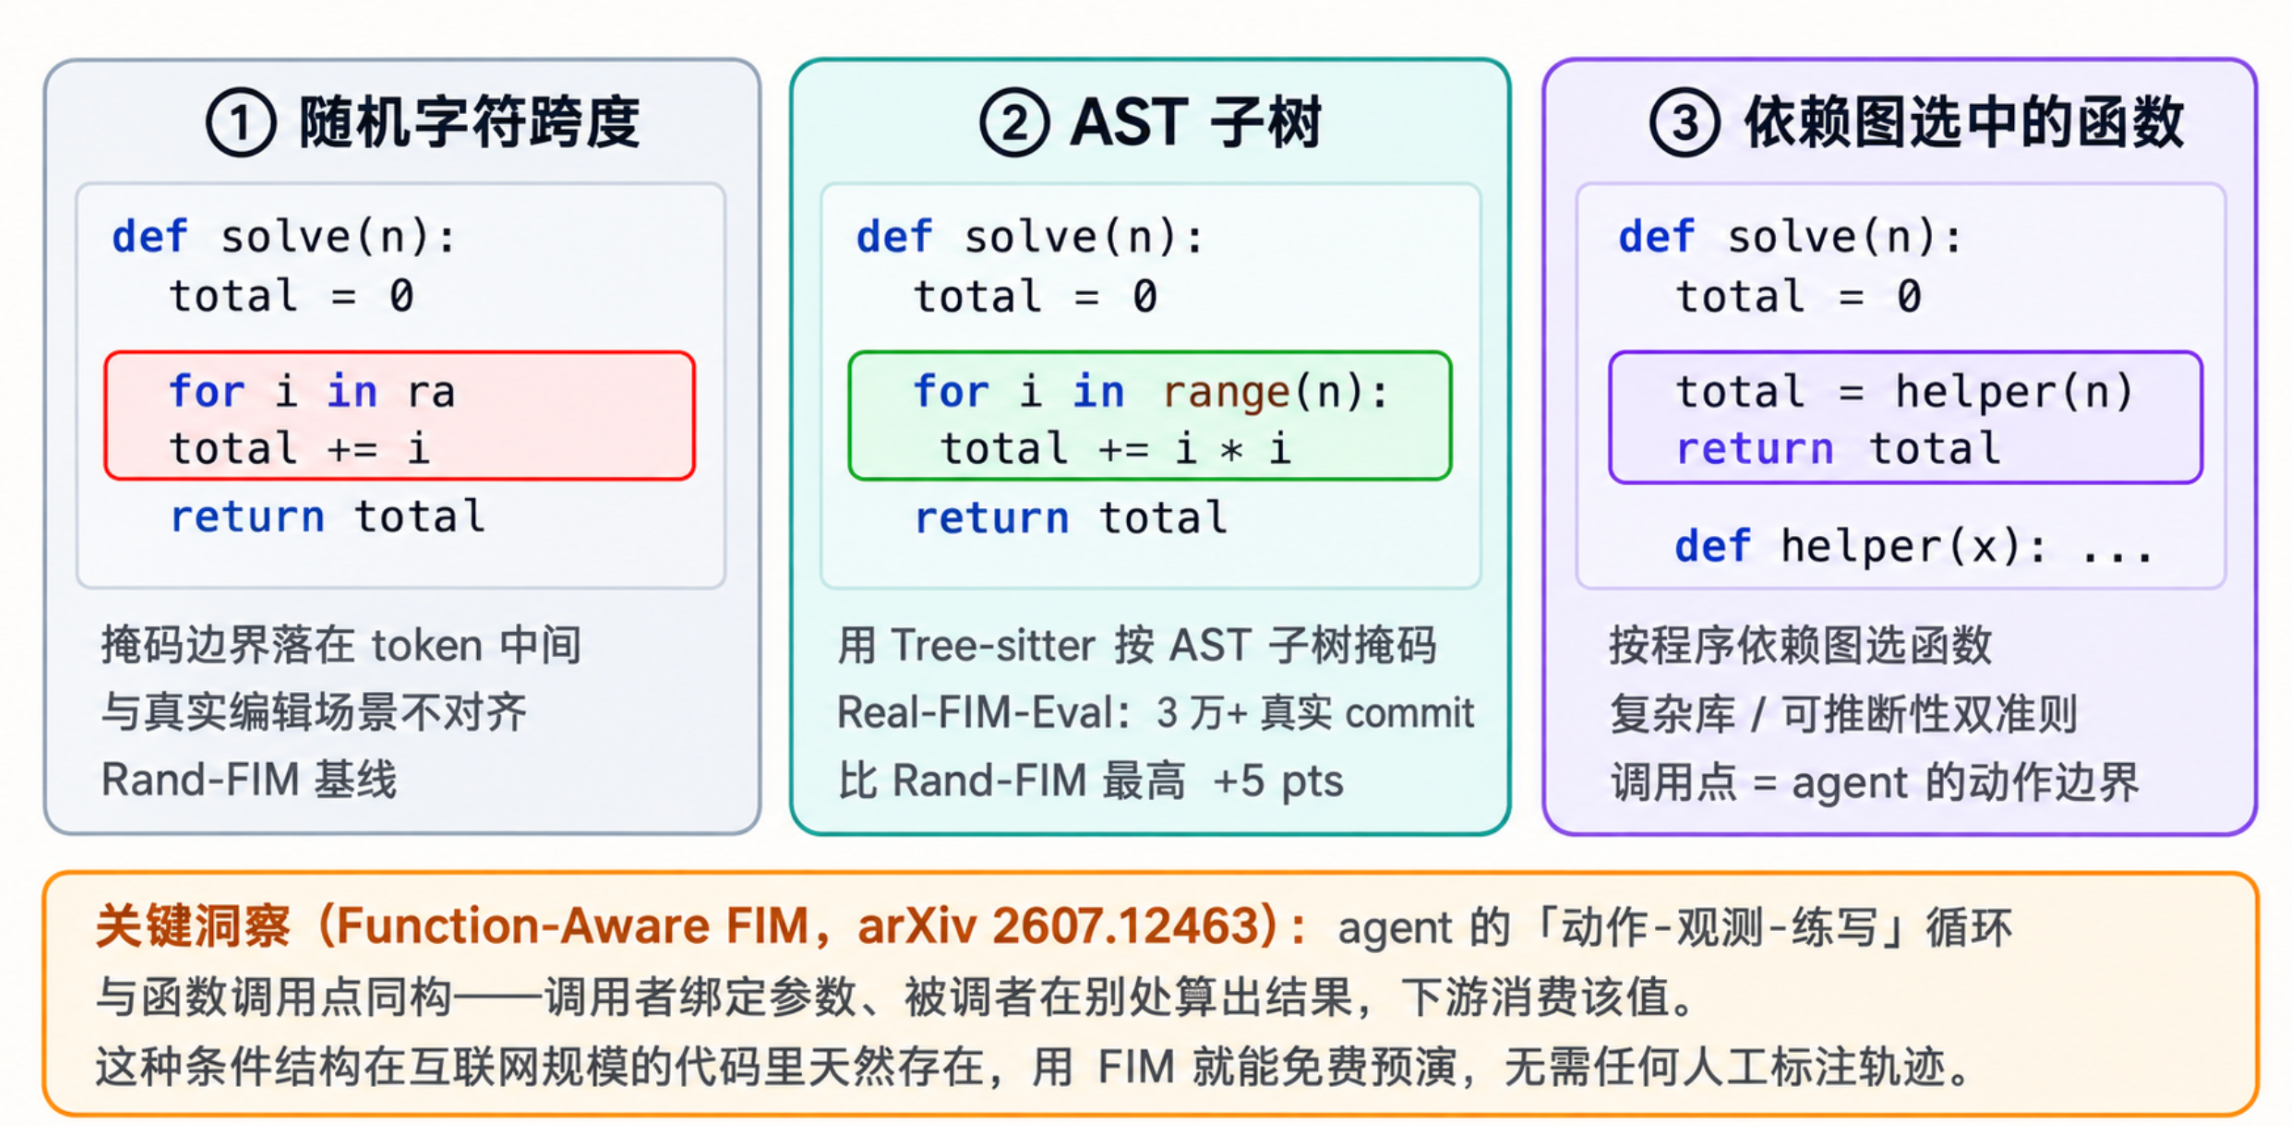
Structure-Aware FIM 通过AST将缺口对齐到语句、函数或其他语法子树,改善训练缺口与代码块编辑的匹配。[34] 随机跨度则覆盖任意光标位置,包括不落在完整语法节点边界的编辑。
该工作使用约70% FIM,FIM内部以AST为主,仍保留约10%随机FIM;不支持解析或解析失败时,可以回退随机切分。其消融表明,去掉随机部分以后,模型容易适应规则化AST缺口,却在随机位置补全上退步。[34,§7]
Function-Aware FIM 进一步按函数复杂度和可推断性选目标,还加入教师生成的 rationale、候选实现和judge筛选,再结合agent后训练。[35] 因此,它同时改变数据选择、掩码、合成与蒸馏信号,收益无法完全归到函数级mask。主要实验为Python,跨语言效果仍需验证。
FIM产物应做逆变换检查,确认切分和重排没有损坏原始内容。Tree-sitter常使用byte offset,处理Unicode、中文注释和tokenizer边界时,应特别核对字节与字符索引。此类错误可能静默进入训练集,不能只靠后续loss发现。
十一、流程 7:多语言训练与低资源配额
代码预训练天生是多语的,但不同语言对规模的响应完全不同. Scaling Laws for Code: Every Programming Language Matters (arXiv 2512.13472)做了1000+次实验、 约336,000 H800卡时, 模型0.2B-14B、数据 1Ttoken, 是目前这个方向最系统的工作.
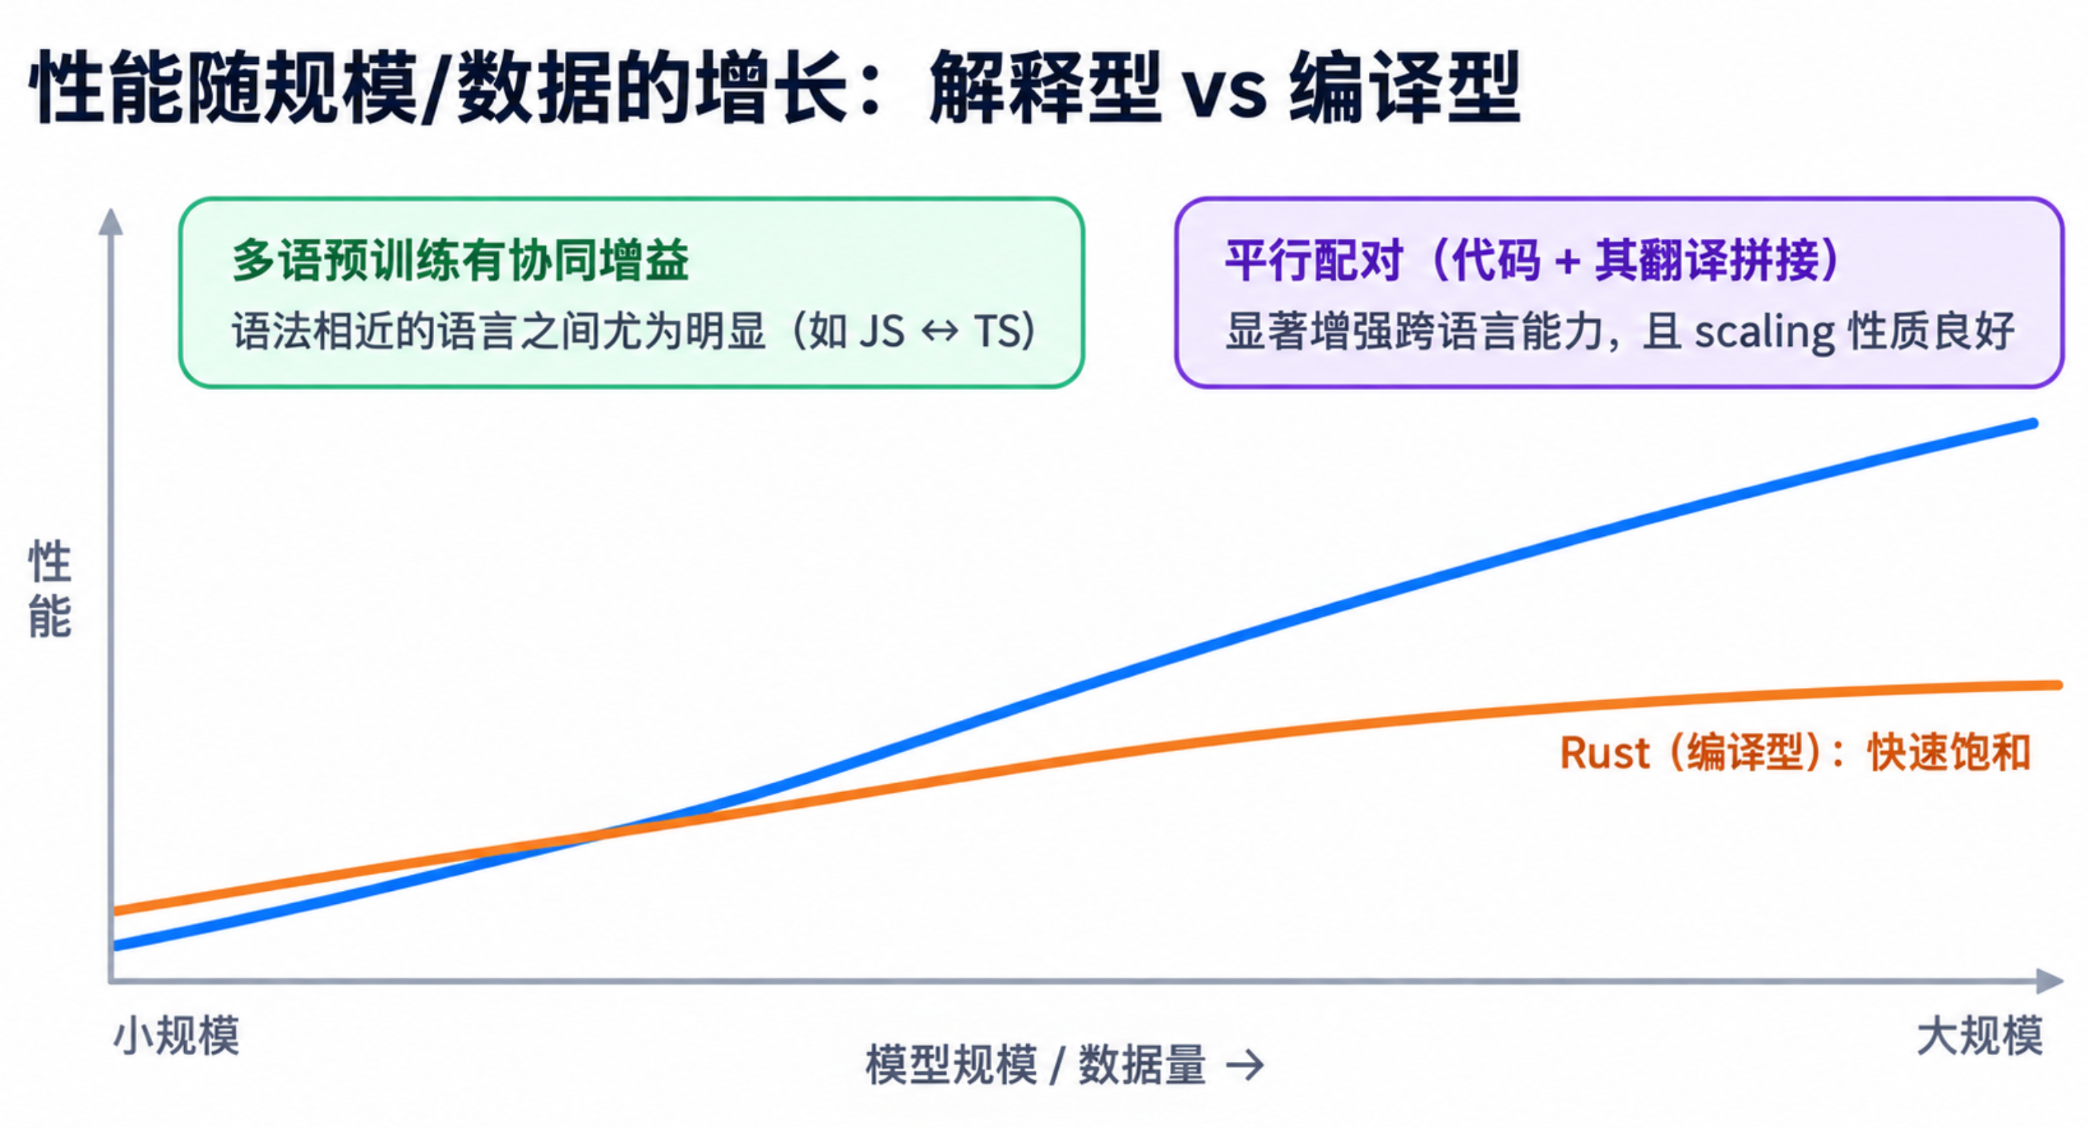
Scaling Laws for Code: Every Programming Language Matters 分别研究单语言缩放、跨语言迁移、程序配对和预算分配。[36] 摘要报告了1000多次实验、约336,000 H800卡时,以及0.2B–14B模型、1T tokens的总体范围;各小节的具体实验并未同时覆盖这些上限,解读时仍应逐组看设置。
单语言对参数和数据的响应
论文对Python、Java、JavaScript、TypeScript、C#、Go、Rust做单语言训练,10档模型规模与6档token预算共形成420个实验,并用下式一类的scaling law拟合验证loss:
$$ L(N,D)=\left(\frac{N_c}{N}\right)^{\alpha_N} +\left(\frac{D_c}{D}\right)^{\alpha_D}+L_\infty. $$N是模型参数量,D是训练数据量。作者观察到不同语言的响应不同,例如Python对规模增长更敏感,Rust在其数据分布下更早出现收益趋缓。[36,§3]
这些拟合还受tokenizer、模板比例、数据来源与翻译风格影响。不同语言的绝对token loss未必可以直接比较,也不能仅凭一个指数决定下一批token的分配;当前数据规模和目标任务表现同样重要。
低资源语言:辅助语言与重复训练
一组实验固定128B tokens,对比64B目标语言训练两遍,与64B目标语言加64B辅助语言。[36,§4] 它回答的是目标语言新数据不足时,辅助语言能否胜过重复已有数据,未证明辅助语言优于同规模的新鲜目标语言数据。
迁移还具有方向性:A帮助B,不意味着B对A有同等增益。语法、类型系统和生态接近的语言可能共享更多结构,但仍需实验确认。该文部分迁移表格与正文解释不完全一致,精确矩阵的含义尚有待澄清,不宜据此确定固定配额。
多语言程序配对
随机混合多语言数据与相邻放置同一程序的不同语言实现,提供的监督不同。配对能够显式呈现实现之间的对应关系,但也会改变各语言的训练分布。
论文表3的7B设置中,五语言平均分从32.46到33.79,Python却从34.15降到26.22,Java则提高。[36,§5] 因此,平均分之外还应按语言验收。翻译数据也要检查惯用写法与执行语义,仅通过编译不足以说明它符合目标语言的常见实现方式。
有约束的配额优化
配额实验使用两个1.5B模型、各400B tokens,其中350B代码、50B FineWeb-Edu。基线在七种语言间均分代码预算,优化方案在总量不变时重新分配。[36,§6]
这说明配额值得作为优化变量,但结果仍限于相应模型、数据池和预算。实际使用时,我会先统计各语言unique数据量与重复率,检查过滤器的系统性误删,再测辅助语言和配对收益,最后在主力语言最低质量要求下分配预算。SQL、Assembly及更低资源的领域语言,还不能直接从这七语言实验得到答案。[36,Limitations]
《A More Data-Hungry Regime》也发现,代码训练在特定设置下可能偏好更高的 D/N ,但继续提高并非始终有利。[37] 这应理解为模型与数据预算的权衡变化,而非单纯要求增加token总量。
十二、流程8:配比与引入时机
正确且合理的数据配比策略也是 Scaling 的非常重要的部分,相关研究比较多,但本文我们并不深入研究和分析数据配比这些。
数据配比需要区分总混合中的代码比例、代码内部的合成比例、各类数据的引入阶段,以及累计曝光和学习率。它们可以相互影响,单看最终比例很难解释结果。
Cohere的《To Code, or Not To Code?》在470M模型、200B-token预算下测试六档代码比例,约25%代码时非代码综合目标较好,而代码专项任务往往偏好更高比例。[38] 该实验没有覆盖连续比例空间,更不能将25%或25–40%直接作为其他通用模型的最优区间。
《Midtraining Bridges Pretraining and Posttraining Distributions》v2的代码实验在70M/160M模型上观察到,较早引入目标数据时可以使用更高权重,较晚引入时高权重可能损害表现。[39] 这个差异还涉及累计曝光和学习率日程,不能直接推成所有大模型都有相同时间窗。
Seed-Coder、OpenCoder和Phi等工作的阶段设计,提供了不同的分布调度实例。[5][7][14][23] 经筛选的代码或改写数据可以较早参与;工具轨迹、交互修复和高成本验证样本是否后置,则要结合目标和数据量另做实验。
我会至少比较较早与较晚引入、较低与较高权重,并固定后训练协议。除域内收益外,同时记录通用能力变化、目标数据曝光、学习率位置和总成本。这样才能区分引入时机的作用与单纯增加目标数据训练量的作用。
十三、流程 9:去污染与评测协议
代码训练与公开评测的重叠可能来自题面、答案、测试、题解、issue、patch、镜像仓库,以及教师生成的改写版本。因此,去污染要沿数据来源和变换过程检查,不能只在最终文件上做一次匹配。
字面匹配与语义候选
《Soft Contamination Means Benchmarks Test Shallow Generalization》检查OLMo 3的部分预训练数据和全部微调数据,先用embedding检索,再做语义标注。 在top-100候选检查中,77.5%的CodeForces题至少有一个被判为语义重复的样本。[40,§3–4]
分母是评测题目数,不是训练样本数或全部重复样本数,所以不能解释为n-gram漏检率77.5%。结果也受候选范围、embedding模型和标注标准影响。
这项研究说明,字面匹配可能遗漏改写与语义等价内容;语义检索则能扩展候选范围,但仍需结合来源和任务含义复核,不能独自保证无污染。
分阶段保留来源关系
在来源阶段,应检查评测仓库及其fork、镜像、题面、答案、测试和patch;变换后,则为原文、翻译、改写、回译题面、生成测试和轨迹保留统一lineage,避免同源变体被拆到不同集合。最终训练集还应再检查hash、n-gram和语义相似候选,以发现拼接或二次生成带回的内容。
Clean-PR同时采用仓库排除、源码哈希、patch子序列和issue相似度检查,因为它们覆盖不同泄漏路径。[13,附录A.6–A.7] 这些措施只描述当前数据集的处理,不能反向证明原始base模型的全部历史训练都与评测独立。
更稳妥的做法,是在不同阶段分别控制可能的泄漏来源。
- 来源阶段: 检查 benchmark 仓库及其 fork、镜像、题面、答案、测试和 patch,并将与评测直接相关的来源排除或单独标记。
- 变换阶段: 对原文、翻译、改写、回译题面、生成测试和衍生轨迹保留统一的 lineage,使同一来源的衍生样本在数据划分时保持一致。
- 最终训练集阶段: 再进行 hash、n-gram 和语义相似度检查,以发现经过拼接、重写或二次生成后重新出现的评测内容。
- 评测阶段: 固定 base model、harness、工具 schema、上下文长度、交互轮数、采样次数和测试可见性,避免把推理配置变化误认为模型本身的能力变化。
时间留出的定义
软件任务通常有多种时间:issue创建与修改、PR创建与合并、commit时间,以及实际抓取或首次观测时间。留出策略应说明使用哪一种。
SWE-bench对题面截断作了处理,避免后续评论里的修复信息进入输入;SWE-rebench持续收集较新的issue和修复,以降低固定评测集长期公开带来的暴露风险。[16][41]
仅按issue创建时间切分,可能把多年后补上的答案也归为早期内容;仅按仓库名隔离,也无法覆盖复制文件和跨仓库镜像。更稳妥的做法是结合内容、仓库或血缘隔离与时间切分。常见算法的相似实现不一定代表泄题,语义候选仍需保留复核过程。
更可靠的方案通常需要组合使用内容级去污染、仓库或血缘级隔离,以及时间戳。同时,语义相似本身并不等价于泄题。常见算法和通用实现模式天然会在不同仓库中重复,因此语义检索更适合作为候选发现步骤,再结合来源和任务语义进行复核。
固定推理与评测配置
pass@1、Exact Match、BLEU、验证loss和软件工程修复率衡量不同能力。即使权重相同,增加采样次数、扩大窗口、更换检索器或暴露更多测试信息,也可能改变分数。[17][27][28]
因此,一个可比较的实验至少应报告:使用的 base model、训练数据版本、unique tokens 与累计训练 tokens、后训练设置、推理预算、评测切分以及具体 harness。对于 agent 或软件工程任务,还应记录工具接口、最大交互轮数和测试可见性。
换句话说,评测结果并不只由模型权重决定,而是由模型、数据、推理配置和评测协议共同决定。 如果这些条件没有被完整记录,不同实验之间的分数就很难进行严格比较。
十四、数据管线的投入顺序
第一步,先建立可追踪、可复现的基线。
如果重新搭建,我会先明确任务和许可政策,冻结输入快照,保存内容、路径、仓库与版本映射,再用稳定tokenizer、基础规则、精确去重和简单采样跑通训练与评测。[5][30] 后续复杂模块都以此为对照。
第二步,优先消除明显冗余和数据实现问题。
之后优先处理明显冗余和实现问题:文件级近去重、跨来源与分区重复、异常大簇、loader和打包后的重复曝光,并按语言统计保留率。[6–9] 基线没有稳定之前,增加评分或语义过滤,很难得到可信的增量结论。
第三步,再评估质量评分与过滤强度。
质量筛选可以在这些检查之后评估。规则、模型分数和随机筛选要尽量保持来源与预算一致,同时观察低资源语言和合法异常样本的误删。公开工作中的10%、28%分别对应不同阶段和分母,需要重新测保留率敏感性。[5][10][11]
第四步,将结构化数据与合成数据拆开验证。
编辑重建、可执行任务、教师轨迹、仓库上下文和FIM则分别验证,再研究组合。特别是选择、蒸馏、mask与后训练一起改变时,应保留能区分主要变量的对照。[13][18][19][35]
第五步,在扩大训练规模之前,先扩大证据。
小模型和数据切片适合先筛方向,但去重收益、长尾覆盖和scaling行为仍需更大规模确认。最终应分别比较等训练tokens、等训练计算量和端到端成本。[8][19][37] 下面这张表整理了可以借用的实验点,以及需要重新验证的内容。
与其给出一组固定参数,更合理的是把公开实验结果作为参考点,并明确哪些量仍需要在本项目中重新验证:
| 决策 | 可参考的公开实验 | 本项目需要重新验证的量 |
|---|---|---|
| 近去重 | FineWeb 的词级 5-gram / 14×8;代码数据采用过不同配置 | 分词方式、候选召回、复核精度、簇结构、最终重复曝光 |
| 文件与仓库组织 | OpenCoder 文件级对照;仓库 manifest 保留 | 局部重复、版本一致性、依赖完整度、仓库级任务收益 |
| 质量评分 | Seed 的 1.3B 回归器、Stack-Edu 教育分类、MIRA 来源感知 | teacher 偏差、尾部误差、来源校准、可用数据量、真实增益 |
| 过滤强度 | Seed 预处理后约删除 10% 文件;Stack-Edu 约保留 28% tokens | 同预算随机基线、重复次数、能力覆盖、保留率敏感性 |
| 合成比例 | 网页改写中约三分之一是已研究设置之一 | 分母定义、生成器、难度、多样性、验证率、端到端成本 |
| 过程数据 | commit 编辑预测;Clean-PR 的 mid-training + SFT | 重建正确性、测试质量、检索误差、harness 匹配、污染 |
| 长上下文 | file-level + 位置适配、路径排序、依赖组织逐层对比 | 有效监督量、相关内容密度、长短任务权衡、训练成本 |
| FIM | PSM/SPM 联合、单一排列、随机/AST/函数级 mask 均有实例 | 格式兼容、FIM rate、mask 定义、光标分布、L2R 回退 |
| 多语言 | 重复基线、辅助语言、平行配对、语言配额优化 | 有向迁移、token 效率、主力语言下限、尺度稳定性 |
| 调度 | 时机与权重联合实验,而非只看最终比例 | 累计曝光、学习率位置、域内收益、通用能力回退 |
| 去污染 | 内容、仓库、时间和合成 lineage 的多层控制 | 候选复核、误杀/漏检、teacher/verifier 污染、新题泛化 |
论文之外,OpenCoder的实践分享也强调规则阈值要通过抽样校准,先在小模型上做较多消融再放大。其他实践笔记反复提到HTML解析、数据格式,以及低perplexity合成语料未必带来对应下游收益。[42] 这类材料适合帮助发现问题,但同一结论的多次转述不等于独立实验。
成本至少应包含以下部分:
$$ C_{\mathrm{total}}=C_{\mathrm{collect}}+C_{\mathrm{process}} +C_{\mathrm{generate}}+C_{\mathrm{verify}} +C_{\mathrm{train}}+C_{\mathrm{evaluate}}. $$生成和验证还要计入失败重试,数据确实被后续多次使用时,才适合摊销相应成本。每百万生成tokens的单价低,不表示每百万去重、验证后可用tokens也便宜;最终仍应比较单位下游收益所需的总成本。[19][30]
因此,数据管线的投入顺序更适合遵循一个原则:先解决可观测、可复现和明显冗余,再逐步增加评分、结构、合成与复杂调度;每增加一层复杂度,都需要对应的受控证据说明它带来了什么额外收益。
结语:好管线不仅生产数据,也生产对数据的解释
回头看,我对代码预训练数据的理解,已经从“尽可能多地收集、尽可能彻底地清洗”,转向更关注一组更具体的问题:为什么要收这类数据,为什么要删掉另一类,哪些重复是有害的,哪些重复是必要曝光,以及最终为什么相信性能提升确实来自这些数据决策。
这些工作的共同难点,是把数据改动与模型效果对应起来。删除重复会改变分布,质量筛选会改变覆盖,改写可能影响接口,仓库组织又会改变监督量。只看最终保留了多少token,通常解释不了这些变化。
The Stack 三代说明,规模之外还需要考虑内容可得性、许可治理与产物质量;OpenCoder 和 FineWeb 表明,去重本身会改变数据分布;Seed-Coder、Stack-Edu 和 MIRA 说明,质量判断必须依赖目标与来源;Clean-PR 和 SWE 系列展示了从静态文本到可执行任务之间不同程度的重建与验证;SwallowCode、FIM 及其结构化变体则进一步表明,改写和数据组织能够提高有效监督,但同时也可能引入接口漂移、分布偏移和新的验证成本。[1–19][29][34][35]
这些工作并没有收敛出一套可以直接复制的统一配方。更有价值的是它们提供了一套分析框架:一项数据操作究竟补充了什么能力,改变了哪些变量,引入了什么成本,是否存在更简单的对照,以及最终评测是否仍与训练过程保持足够独立。
我现在更在意的是,每次修改管线后,能否说清输入发生了什么变化,用什么对照判断收益,以及哪些任务有所退步。这也是我理解的数据与Infra工作的关系:处理过程能够追踪和复现,才有条件继续讨论数据策略是否有效。
术语速查
| 术语 | 本文中的含义 |
|---|---|
| unique / consumed tokens | 独立语料中的token量 / 经采样重复后累计训练消耗 |
| manifest / lineage | 数据清单与版本映射 / 原始、变换、合成和训练样本的血缘关系 |
| SWHID | 平台无关的软件对象标识;不是许可凭证或无限下载保证 |
| MinHash / LSH | 估计集合相似度的签名 / 高效召回可能相似对象的索引方法 |
| Jaccard / shingle | 集合交并比 / 用于比较的连续片段,须说明字符、词或其他单位 |
| rehydration | 去重后利用重复簇等信息重新分配训练重复权重 |
| scorer / rubric | 质量评分模型 / 评分维度与标准;不等于功能正确性证明 |
| round-trip verification | 编辑表示应用回旧代码后,能否精确重建目标版本 |
| F2P / P2P / P2F | 指定测试的失败转通过 / 通过保持通过 / 通过转失败 |
| test oracle | 决定输出或行为是否符合要求的判断依据,不只是测试执行器 |
| CPT / mid-training / SFT | 持续预训练 / 基础与后训练之间的过渡训练 / 监督微调;需跟随论文定义 |
| FIM / PSM / SPM | 中间填空数据变换 / 前缀-后缀-中间 / 后缀-前缀-中间 |
| AST / 依赖图 | 语法结构树 / 文件或程序对象之间的静态关系近似 |
| RoPE / theta | 旋转位置编码 / 基频参数;调整参数不等于完成训练适配 |
| EM / pass@1 / BLEU | 字符串精确匹配 / 单样本通过率 / 文本重叠指标,不能互换 |
| 百分点 / 相对提升 | 25%−20%=5个百分点;(25−20)/20=25%相对提升 |
附录:整体流程路线与建议
如果从头搭一条流水线,按这个顺序做:
- 精确去重(内容哈希)
去掉完全重复文件和镜像副本,先消除最明显的数据冗余。 - 文件级 MinHash 近去重
识别轻微改写、格式变化、注释变化导致的近重复代码。 - 语言识别 + Tree-sitter 语法过滤 + License/PII
保证代码语言正确、语法可解析,同时过滤许可风险和敏感信息。 - 训练质量打分器
抽样约 20 万条让强模型打分,再训练轻量 scorer 扩展到全量数据。 - 过滤最低质量档,保留 70%–90%
去掉明显低质量样本,同时避免过度清洗导致数据分布变窄。 - 按来源分四类(文件 / 仓库 / 演化 / 合成)
将不同结构和用途的数据分桶,为后续采样和课程调度做准备。 - 三阶段数据调度,结构化数据后置
先学基础代码能力,再学仓库上下文,最后引入演化和合成类复杂数据。 - 依赖图重建仓库顺序 + 结构感知 FIM
按依赖关系组织仓库文件,并让 FIM 利用函数、文件和跨文件结构信息。 - n-gram 去污 + 语义去污
同时检测表面文本重合和语义近似,降低 benchmark 泄漏风险。 - 时间切分内部留出集
用未来时间段数据构建内部评测集,作为数据策略和 checkpoint 的最终裁决依据。
| 参数 | 推荐取值 | 依据 |
|---|---|---|
| MinHash 参数 | 5-gram、112 hash、14 band × 8 row;阈值按语言样本实测后定 | FineWeb 的性价比点;命中率在 0.75→0.85 之间从 77% 跳到 98.8% |
| 去重粒度 | 文件级;仓库结构在打包阶段重建 | OpenCoder:仓库级去重保留 3× token 但下游更差,且 68.4% 残留可再按文件级去重 |
| 超大簇处置 | N≥1000 的簇权而非保留 | FineWeb2 的簇大小理水化策略 |
| 质量过滤强度 | 保守:只滤最差一档(10% 量级),不做“只留 1% 精品” | Seed-Coder 滤 10%;代码最优 D/N 高于文本(2510.08702) |
| 打分器 | 强 LLM 标注 20 万级样本 → 蒸馏 1B 级打分器 → 全语料推理 | Seed-Coder(1.3B)、Stack-Edu(StarEncoder) |
| 评分维度 | 按数据源分别发现维度,而不是一套固定 rubric | MIRA:半量 token 追平全量 |
| FIM 格式 / 粒度 / 比例 | SPM;结构感知掩码(AST 子树或依赖图选函数);常规 0.5 → 持续预训练 0.1,别用 0.7+ | 2207.14255、2506.00204、2607.12463 |
| 合成数据形态 | 优先改写型;教科书型控制比例 | Meta(2510.01631):1/3 改写 + 2/3 真实提速 5–10×;教科书型 33% < 67% |
| 合成数据比例 | ≈30%(随模型规模与数据预算微调) | Meta 的经验收敛值 |
| 代码在通用预训练中的占比 | 25–40% 是反复出现的甜点;100% 伤世界知识 | Cohere(2408.10914);另有研究显示算术类峰值在 40–50% |
| mid-training 时机 | 早引入 + 高权重;晚引入只能用低权重 | 2510.14865:晚期加大配比无法补偿错过窗口 |
| 长上下文扩成本 | 只需预训练预算的 0.1%–1%;重点是 RoPE θ 阶梯重标定 | Granite 4B token(0.1%);JetBrains 1B token(有效 72M) |
| 去污 | 8–13 gram 必做,补 embedding 语义检索,最好再建时间切分留出集 | n-gram 漏掉 78% 的 CodeForces 语义重复 |
| 去污 n-gram 长度 | 8(s1 / open-r1)、10(Seed-Coder)、13(SmolLM / Llama 系) | 各家实践 |
参考文献与延伸阅读
以下按正文编号整理。论文结果均以所列版本为准;动态数据卡尤其应锁定revision。部分近作尚属预印本,引用表示可核读,不表示本文完成独立复现。
- Kocetkov et al. The Stack: 3 TB of permissively licensed source code. 2022,v1。§3、表3/5/6。论文
- BigCode. The Stack 数据卡。初始与后续版本、许可修订。数据卡
- Lozhkov et al. StarCoder 2 and The Stack v2: The Next Generation. 2024,核读v1,§2–4。正文
- BigCode. The Stack v2 数据卡。数据发布物与访问安排。数据卡
- Zhang et al. Seed-Coder: Let the Code Model Curate Data for Itself. 2025,v2,§2与附录A。正文
- HuggingFaceCode. The Stack v3. 2026。固定修订README · 同修订训练统计 · full说明
- Huang et al. OpenCoder: The Open Cookbook for Top-Tier Code Large Language Models. 2024/2025,v3;来源表亦核对v1原始HTML。正文
- Penedo et al. The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale. 2024,v2,§3.4、附录E。正文 · 官方长文
- Penedo et al. FineWeb2: One Pipeline to Scale Them All. 2025,v1,§4.3–4.5。正文
- SmolLM2: When Smol Goes Big — Data-Centric Training of a Small Language Model. 2025,v1,表2、附录D。正文 · Stack-Edu
- MIRA: Mid-training Rubric Anchoring for Source-Aware Data Selection. 2026,v2,表1、附录A。预算/checkpoint文字存在不完全一致之处,正文只采用明确表格比较。正文
- Muennighoff et al. OctoPack: Instruction Tuning Code Large Language Models. 2023/2024。论文 · CommitPackFT官方卡
- Pull Requests as a Training Signal for Repo-Level Code Editing(Clean-PR). 2026,v2,表2–9、附录A。正文 · Microsoft Research发表页
- Gunasekar et al. Textbooks Are All You Need. 2023,v2,§2、§5。论文
- Training Software Engineering Agents and Verifiers with SWE-Gym. 2024/2025,v2,§3–4。正文
- SWE-rebench: An Automated Pipeline for Task Collection and Decontaminated Evaluation of Software Engineering Agents. 2025,v2。正文
- R2E-Gym: Procedural Environments and Hybrid Verifiers for Scaling Open-Weights SWE Agents. 2025,v1。正文
- SWE-Mirror: Scaling Issue-Resolving Datasets by Mirroring Issues Across Repositories. 2025,v1,§2–3、表6。PDF
- Rewriting Pre-Training Data Boosts LLM Performance in Math and Code(SwallowCode). 2025/2026,v4,§3、附录G/I。正文
- Demystifying Synthetic Data in LLM Pre-training: A Systematic Study of Scaling Laws, Benefits, and Pitfalls. arXiv记录为2025 v1,正文日期及比例网格有不一致;不据此采用精确最优比例。正文
- UnitCoder: Scalable Code Synthesis from Pre-training Corpora. EMNLP 2025,§3–4。正式论文
- KodCode: A Diverse, Challenging, and Verifiable Synthetic Dataset for Coding. 2025,v2,§2–3。正文
- Phi-4 Technical Report. 2024,表4–5、附录B。正文
- Shumailov et al. AI models collapse when trained on recursively generated data. Nature,2024。论文
- Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data. 2024,v2。正文
- Scaling Granite Code Models to 128K Context. 2024,v1,§2–3。正文
- On Pretraining for Project-Level Code Completion. 2025,v1,§3、表3–4。正文
- OctoLong: Mid-Training On Cross-Repository Code Contexts Enhances Long-Context Modeling. 2026,v1,§3–5、附录B/C。正文
- Bavarian et al. Efficient Training of Language Models to Fill in the Middle. 2022,v1,§3–5、§8。正文
- Hugging Face. DataTrove。仓库 · MinHash分阶段示例
- IBM / data-prep-kit. Repo Level Order Transform。本次核读dev分支,不作为稳定API承诺。说明
- GitHub Docs. Viewing and understanding files;Software Heritage软件标识说明。GitHub历史查看 · SWHID标准说明
- DeepSeek-Coder,2024,v2,§3.1.2;StarCoder,2023,v2,训练格式小节。DeepSeek-Coder · StarCoder
- Structure-Aware Fill-in-the-Middle Pretraining for Code. 2025,v1,§3、§5–7。正文
- Function-Aware Fill-in-the-Middle as Mid-Training for Coding Agent Foundation Models. 2026,v3,§2–3、§6。正文
- Scaling Laws for Code: Every Programming Language Matters. 2025,v1,§3–6、表3。部分迁移表和规模口径需谨慎解读。正文
- Scaling Laws for Code: A More Data-Hungry Regime. 2025/2026,v2,§3–4。正文
- To Code, or Not To Code? Exploring Impact of Code in Pre-training. 2024,v1,§3.3。正文
- Midtraining Bridges Pretraining and Posttraining Distributions. 2025/2026,v2,§5–6。正文
- Soft Contamination Means Benchmarks Test Shallow Generalization. 2026,v1,§3–4。正文
- Jimenez et al. SWE-bench: Can Language Models Resolve Real-World GitHub Issues? . 2023起始工作,附录A;SWE-smith: Scaling Data for Software Engineering Agents,2025,v2。SWE-bench · SWE-smith
- 社区实践,作为定性经验而非独立实验:crazycth《OpenCoder:顶尖代码大模型的开源实践全指南》、 《LLM Pretrain Data Project》;真中合欢《LLM实践–数据去重:Simhash&Minhash 原理分析&代码实现》;字节跳动Seed官方中文解读。OpenCoder分享 · 预训练实践 · 去重实现讨论 · Seed官方解读